第3章 分布の特性値(統計検定準1級)
このページはプロモーション(広告)を含みます。
『統計学実践ワークブック』第3章に対応する参考書の本文です(無料公開)。この章の練習問題 10 問もあります。
分布の「位置」(平均・中央値・最頻値・分位点),「ばらつき」(分散・標準偏差),「形」(歪度・尖度)を表す特性値を,図と結びつけて理解し計算できるようにする.
共分散・相関係数・条件付き期待値・条件付き分散を定義から計算でき,繰り返し期待値の法則と分散の分解公式を導出・活用できるようにする.
線形変換で特性値がどう変わるかを整理し,コーシー=シュワルツの不等式から $|\rho|\le1$ を証明できるようにする.
標本平均・不偏分散・標本歪度などデータの特性値を計算し,なぜ不偏分散は $n-1$ で割るのかを説明できるようにする.
平均ベクトルと分散共分散行列を行列で扱い,${\operatorname{E}}[A{\boldsymbol{X}}]=A{\boldsymbol{\mu}}$,${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$ を線形代数の基礎から理解する.
| ワークブックの節 | WB頁 | 本書での扱い |
|---|---|---|
| 確率変数の分布の特性値 | p.13 | 3.1節(平均・分散・モーメント・歪度・尖度・分位点・中央値・最頻値) |
| 同時分布の特性値 | p.15 | 3.2節(共分散・相関係数・条件付き期待値・条件付き分散・分散の分解) |
| 特性値の性質 | p.16 | 3.3節(線形変換,コーシー=シュワルツの不等式,$|\rho|\le1$,チェビシェフの不等式) |
| データの特性値 | p.17 | 3.4節(標本平均・標本分散・不偏分散・標本歪度・標本尖度・標本相関係数) |
| 平均ベクトルと分散共分散行列 | p.18 | 3.5節(行列表記,${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$,線形代数の補足) |
| 例題 | p.18 | 3.6節(例題に取り組むための考え方)(演習は問題集 第3章) |
◆合格基盤 まず読む:3.1節(モーメント,歪度・尖度),3.2節(条件付き期待値,分散の分解),3.3節(線形変換での変化,$|\rho|\le1$,チェビシェフの不等式),3.4節(不偏分散),3.5節の ${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$
◇満点補強 後から補う:3.4節の標本歪度・標本尖度の流儀の違い,3.5節の2次形式の期待値・相関行列
+背景・発展 初回は飛ばしてよい:3.3節のコーシー=シュワルツの不等式の証明(結論 $|\rho|\le1$ と等号条件は◆)
前提:第1章(期待値・分散・共分散),第2章(同時分布,条件付き密度,キュムラント)
演習:◆ 問3.1〜問3.4,問3.6〜問3.9,◇ 問3.5,問3.10.到達確認は 問3.4,問3.9
第2章では,分布そのもの(分布関数・密度・母関数)を扱いました.しかし分布は関数なので,全体を一度に把握するのは大変です.そこで,分布の特徴を少数の数値に要約したものが特性値です.「平均はどこか」「どれくらい散らばっているか」「左右対称か」「裾は重いか」── 私たちが分布の図を見て感じ取ることを,数値にしたものだと思ってください.
この章の内容は,後の章のほぼすべてで使われます.特に,分散の分解(3.2節)は第20章の分散分析や第31章のベイズ法に,分散共分散行列(3.5節)は第16章の重回帰分析や第22章以降の多変量解析に直結します.ワークブックはこの章を6ページ程度で述べていますが,本書では1つずつ丁寧に導出します.
3.1確率変数の分布の特性値◆合格基盤
3.1.1位置を表す特性値 ── 平均・中央値・最頻値
平均(期待値):$\mu={\operatorname{E}}[X]$.
中央値(メディアン):$P(X\le m)\ge\frac12$ かつ $P(X\ge m)\ge\frac12$ を満たす $m$.連続型なら $F(m)=\frac12$ の解.
最頻値(モード):確率関数 $p(x)$ または密度関数 $f(x)$ を最大にする $x$.
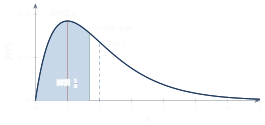
平均は密度の形をした板の重心(つり合う点).
中央値は密度の下の面積を左右半分ずつに分ける点.
最頻値は密度の山の頂上.
左右対称な山型の分布ではこの3つが一致しますが,右に裾の長い分布(所得・待ち時間など)では,遠くの大きな値が重心を右に引っ張るため,典型的に「最頻値 $<$ 中央値 $<$ 平均」の順に並びます(図3.1).
$X\sim\mathrm{Ex}(\lambda)$ の平均・中央値・最頻値を求めよ.
解 平均は $1/\lambda$(第2章).中央値は $F(m)=1-e^{-\lambda m}=\frac12$ より $m=\dfrac{\log 2}{\lambda}\approx\dfrac{0.693}{\lambda}$.密度 $\lambda e^{-\lambda x}$ は $x=0$ で最大なので最頻値は $0$.「最頻値 $0<$ 中央値 $0.693/\lambda<$ 平均 $1/\lambda$」となっています.
定数 $c$ で $X$ を予測するとき,$${\operatorname{E}}[(X-c)^2]\ \text{を最小にする}\ c={\operatorname{E}}[X],\qquad {\operatorname{E}}|X-c|\ \text{を最小にする}\ c=\text{中央値}.$$ 前者は ${\operatorname{E}}[(X-c)^2]={\operatorname{V}}[X]+({\operatorname{E}}[X]-c)^2$ と分解できることからすぐ分かります(第2項が $0$ になる $c$ が最適).この分解は第8章の平均二乗誤差 ${\operatorname{MSE}}=\text{分散}+\text{バイアス}^2$ と同じ形です.
3.1.2分位点
$0<\alpha<1$ に対し,$F(x)\ge\alpha$ となる最小の $x$ を下側 $100\alpha\%$ 点($\alpha$ 分位点)という.連続型で $F$ が狭義単調なら,$F(x_\alpha)=\alpha$ の解 $x_\alpha=F^{-1}(\alpha)$.
$\alpha=\frac14,\frac12,\frac34$ の分位点をそれぞれ第1四分位点,中央値,第3四分位点といい,その差 $Q_3-Q_1$ を四分位範囲(IQR)といいます.
統計検定の付表や本書・ワークブックでは,$z_\alpha$ は上側 $100\alpha\%$ 点,すなわち $P(Z>z_\alpha)=\alpha$ を満たす点を表すのが普通です($z_{0.025}=1.96$).上の定義の「下側 $\alpha$ 分位点」とは向きが逆で,$z_\alpha$ は下側 $1-\alpha$ 分位点です.問題文がどちらを指しているか,必ず確認しましょう.
3.1.3ばらつきを表す特性値とモーメント
分散 $\sigma^2={\operatorname{V}}[X]={\operatorname{E}}[(X-\mu)^2]$ と標準偏差 $\sigma$ は第1章で扱いました.ここでは,より一般的なモーメント(積率)という枠組みで整理します.
$r=1,2,\dots$ に対し,$$\begin{aligned} \mu_r'&={\operatorname{E}}[X^r] &&(\text{原点まわりの \(r\) 次モーメント}),\\ \mu_r&={\operatorname{E}}[(X-\mu)^r] &&(\text{平均まわりの \(r\) 次モーメント}) \end{aligned}$$ という(${\operatorname{E}}[|X|^r]<\infty$ のとき定義される).$\mu_1'=\mu$,$\mu_1=0$,$\mu_2=\sigma^2$.
$r$ 次のモーメントが有限なら,それより低い次数のモーメントもすべて有限です.しかし逆は成り立ちません.たとえば自由度3の $t$ 分布は分散が有限ですが4次モーメントが無限大で,尖度が定義できません(自由度 $\nu$ の $t$ 分布は $\nu$ 未満の次数のモーメントしかもたない.第6章).コーシー分布は平均すら存在しません.「分散が有限」だけでは,歪度(3次)・尖度(4次)の存在は保証されない点に注意しましょう.
$$\begin{aligned} \mu_2&=\mu_2'-\mu^2,\\ \mu_3&=\mu_3'-3\mu\mu_2'+2\mu^3,\\ \mu_4&=\mu_4'-4\mu\mu_3'+6\mu^2\mu_2'-3\mu^4. \end{aligned}$$
$\mu_3$ の場合到達度:導出 $(X-\mu)^3=X^3-3\mu X^2+3\mu^2X-\mu^3$ の期待値をとると$\mu_3'-3\mu\mu_2'+3\mu^2\cdot\mu-\mu^3=\mu_3'-3\mu\mu_2'+2\mu^3$.$\mu_4$ も $(X-\mu)^4$ を二項展開して同様に得られる($+4\mu^3\cdot\mu-\mu^4=3\mu^4$ の部分に注意).
□
3.1.4形を表す特性値 ── 歪度と尖度
$$\text{\textbf{歪度}}\quad\beta_1=\frac{\mu_3}{\sigma^3}={\operatorname{E}}\Bigl[\Bigl(\frac{X-\mu}{\sigma}\Bigr)^3\Bigr],\qquad \text{\textbf{尖度}}\quad\beta_2=\frac{\mu_4}{\sigma^4}={\operatorname{E}}\Bigl[\Bigl(\frac{X-\mu}{\sigma}\Bigr)^4\Bigr].$$ ただし $0<\sigma^2<\infty$ で,歪度には ${\operatorname{E}}[|X|^3]<\infty$,尖度には ${\operatorname{E}}[X^4]<\infty$ を仮定する.正規分布では $\beta_1=0$,$\beta_2=3$.そのため $\beta_2-3$ を尖度と呼ぶ流儀もある(超過尖度).
標準化した値 $Z=(X-\mu)/\sigma$ を考えます.
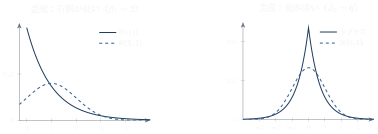
$Z^3$ は符号を保つので,右に大きく外れた値は大きな正,左に大きく外れた値は大きな負の寄与をします.右裾が長ければ正の寄与が勝って歪度 $>0$(右に歪んだ分布),左裾が長ければ歪度 $<0$.左右対称なら打ち消し合って0です.
$Z^4$ は常に正で,しかも $|Z|$ が大きいところを極端に強調します($|Z|=3$ なら $81$).まれに大きく外れる値がある分布,すなわち裾が重い分布ほど尖度は大きくなります.
標準化してから3乗・4乗するので,歪度と尖度は単位や尺度によらない「形だけ」の指標です.
(a) $X\sim\mathrm{U}(0,1)$,(b) $X\sim\mathrm{Ex}(1)$ の歪度・尖度を求めよ.
解 (a) $\mu=\frac12$,$\sigma^2=\frac1{12}$.$Y=X-\frac12\sim\mathrm{U}(-\frac12,\frac12)$ で,対称なので $\mu_3=0$.$\mu_4=\int_{-1/2}^{1/2}y^4\,\mathrm{d}y=\frac{2}{5}\cdot\frac{1}{32}=\frac1{80}$.$\beta_2=\dfrac{1/80}{(1/12)^2}=\dfrac{144}{80}=1.8$.正規分布の3より小さい(裾がない).
(b) ${\operatorname{E}}[X^r]=r!$($\int_0^\infty x^re^{-x}\,\mathrm{d}x=\Gamma(r+1)$).$\mu=1$,$\mu_2'=2$,$\mu_3'=6$,$\mu_4'=24$.公式より $\mu_2=2-1=1$,$\mu_3=6-3\cdot2+2=2$,$\mu_4=24-4\cdot6+6\cdot2-3=9$.$\beta_1=2/1=2$,$\beta_2=9/1=9$(超過尖度6).キュムラントから求めても $K(t)=-\log(1-t)$ より $\kappa_3=2,\ \kappa_4=6$ で,$\kappa_3/\kappa_2^{3/2}=2$,$\kappa_4/\kappa_2^2=6$ と一致します(第2章).
ワークブックp.13〜14では,平均・分散・歪度・尖度・分位点・中央値・最頻値がまとめて定義されています.読むときに注意したい点は次のとおりです.
尖度の定義:$\mu_4/\sigma^4$ そのものを尖度とするか,3を引いたものを尖度とするかは文献によって異なります.ワークブックでどちらが使われているかを必ず確認し,問題を解くときも問題文の定義に従いましょう.3を引く形はキュムラント $\kappa_4/\kappa_2^2$(第2章)に一致し,正規分布で0になります.
中央値の定義が不等式2本で書かれているのは,離散型では $F(m)=\frac12$ となる $m$ が存在しない(または区間になる)ことがあるからです.たとえば $\mathrm{Bin}(3,\frac12)$ では $F(1)=\frac12$ で,$1\le m\le 2$ のどれもが条件を満たします.
平均まわりのモーメントを原点まわりのモーメントで表す式は,二項展開を丁寧に行えば必ず導けます.丸暗記せず,$\mu_3$ まで自力で出せるようにしておきましょう.
3.2同時分布の特性値◆合格基盤
3.2.1共分散と相関係数
第1章で導入した共分散と相関係数を,同時分布から計算する方法を確認します.
$\mu_X={\operatorname{E}}[X]$,$\mu_Y={\operatorname{E}}[Y]$ として$${\operatorname{Cov}}[X,Y]={\operatorname{E}}[(X-\mu_X)(Y-\mu_Y)]=\iint(x-\mu_X)(y-\mu_Y)f(x,y)\,\mathrm{d}x\,\mathrm{d}y,$$ $$\rho_{XY}={\operatorname{Corr}}[X,Y]=\frac{{\operatorname{Cov}}[X,Y]}{\sqrt{{\operatorname{V}}[X]}\sqrt{{\operatorname{V}}[Y]}}.$$ 計算には ${\operatorname{Cov}}[X,Y]={\operatorname{E}}[XY]-{\operatorname{E}}[X]{\operatorname{E}}[Y]$ を使うことが多い.
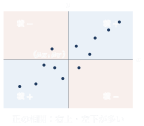
平均の点 $(\mu_X,\mu_Y)$ を原点として平面を4つに分けます.右上と左下の象限では $(x-\mu_X)(y-\mu_Y)>0$,右下と左上では $<0$ です.共分散はこの積を確率で重み付けて平均したものなので,「右上・左下に多く分布していれば正,右下・左上に多ければ負」になります(図3.3).
第2章の例で扱った $f(x,y)=x+y\ (0<x,y<1)$ について,${\operatorname{Cov}}[X,Y]$ と $\rho_{XY}$ を求めよ.
解 $f_X(x)=x+\frac12$ なので$${\operatorname{E}}[X]=\int_0^1x\Bigl(x+\frac12\Bigr)\,\mathrm{d}x=\frac13+\frac14=\frac7{12},\qquad {\operatorname{E}}[X^2]=\int_0^1x^2\Bigl(x+\frac12\Bigr)\,\mathrm{d}x=\frac14+\frac16=\frac5{12}.$$ ${\operatorname{V}}[X]=\frac5{12}-\frac{49}{144}=\frac{11}{144}$.対称性から $Y$ も同じ.$${\operatorname{E}}[XY]=\int_0^1\!\!\int_0^1xy(x+y)\,\mathrm{d}x\,\mathrm{d}y=\int_0^1\!\!\int_0^1(x^2y+xy^2)\,\mathrm{d}x\,\mathrm{d}y=\frac13\cdot\frac12+\frac12\cdot\frac13=\frac13 .$$ ${\operatorname{Cov}}[X,Y]=\frac13-\frac{49}{144}=-\frac1{144}$,$\rho_{XY}=\dfrac{-1/144}{11/144}=-\dfrac1{11}\approx-0.091$.弱い負の相関です.
3.2.2条件付き期待値
$X=x$ が与えられたときの $Y$ の条件付き期待値を$${\operatorname{E}}[Y\mid X=x]=\int_{-\infty}^{\infty}y\,f_{Y\mid X}(y\mid x)\,\mathrm{d}y\qquad(\text{離散型なら }\textstyle\sum_y y\,p_{Y\mid X}(y\mid x))$$ で定める(${\operatorname{E}}[|Y|]<\infty$ を仮定する).これは $x$ の関数なので $m(x)$ と書くと,$m(X)$ という確率変数を ${\operatorname{E}}[Y\mid X]$ と書く.
ここが最初のつまずきポイントです.${\operatorname{E}}[Y\mid X=x]$ は数($x$ を決めれば決まる値),${\operatorname{E}}[Y\mid X]$ は確率変数($X$ の関数)です.
$X$:所属クラス,$Y$:テストの点数とします.${\operatorname{E}}[Y\mid X=x]$ は「クラス $x$ の平均点」で,クラスを指定すれば決まる数です.一方 ${\operatorname{E}}[Y\mid X]$ は,生徒を1人無作為に選んだとき「その生徒のクラスの平均点」を返す量で,どのクラスの生徒が選ばれるかによって値が変わる確率変数です.
ワークブックp.15〜16では,条件付き期待値が ${\operatorname{E}}[Y\mid X]=\int y f_{Y\mid X}(y\mid X)\,\mathrm{d}y$ のように書かれています.
誤植:お持ちの刷によっては,p.16の13行目に $\int y f_{Y\mid X}(y)dy$ とありますが,正しくは $\displaystyle\int y\,f_{Y\mid X}(y\mid X)\,dy$ です(正誤表で訂正).条件付き密度には必ず「何を条件にしているか」を表す $\mid X$ が必要で,これがないと $X$ への依存が消えてしまい,${\operatorname{E}}[Y\mid X]$ が $X$ の関数であることが見えなくなります.
積分の中の条件の部分が小文字 $x$ ではなく大文字 $X$ になっているのは,「$X$ の値を代入した関数」=確率変数としての条件付き期待値を表すためです.$y$ について積分した後に $x$ の関数 $m(x)$ が残り,そこに $X$ を代入したものが ${\operatorname{E}}[Y\mid X]$ です.
$${\operatorname{E}}\bigl[{\operatorname{E}}[Y\mid X]\bigr]={\operatorname{E}}[Y].$$ より一般に,$X$ の関数 $g(X)$ について ${\operatorname{E}}[g(X)\,Y\mid X]=g(X)\,{\operatorname{E}}[Y\mid X]$,${\operatorname{E}}[g(X)Y]={\operatorname{E}}\bigl[g(X){\operatorname{E}}[Y\mid X]\bigr]$.
連続型到達度:理解 ${\operatorname{E}}[Y\mid X]=m(X)$ の期待値は $X$ の分布で平均するので$$\begin{aligned} {\operatorname{E}}[m(X)]&=\int m(x)f_X(x)\,\mathrm{d}x=\int\Bigl(\int y\frac{f(x,y)}{f_X(x)}\,\mathrm{d}y\Bigr)f_X(x)\,\mathrm{d}x\\ &=\iint y\,f(x,y)\,\mathrm{d}y\,\mathrm{d}x={\operatorname{E}}[Y]. \end{aligned}$$ $f_X(x)$ が約分されるところがポイントです.2つ目の性質は「$X$ を固定すれば $g(X)$ は定数なので外に出せる」ということです.
□
3.2.3条件付き分散と分散の分解
$$\begin{aligned} {\operatorname{V}}[Y\mid X=x]&={\operatorname{E}}\bigl[(Y-{\operatorname{E}}[Y\mid X=x])^2\bigm| X=x\bigr]\\ &={\operatorname{E}}[Y^2\mid X=x]-\bigl({\operatorname{E}}[Y\mid X=x]\bigr)^2 . \end{aligned}$$ $x$ に $X$ を代入したものを ${\operatorname{V}}[Y\mid X]$ と書く(これも確率変数).
${\operatorname{V}}[Y]<\infty$ のとき$${\operatorname{V}}[Y]={\operatorname{E}}\bigl[{\operatorname{V}}[Y\mid X]\bigr]+{\operatorname{V}}\bigl[{\operatorname{E}}[Y\mid X]\bigr].$$
分散の分解の導出到達度:導出 $m(X)={\operatorname{E}}[Y\mid X]$ とおく.条件付き分散の定義から ${\operatorname{V}}[Y\mid X]={\operatorname{E}}[Y^2\mid X]-m(X)^2$ なので,両辺の期待値をとってタワー性を使うと$${\operatorname{E}}\bigl[{\operatorname{V}}[Y\mid X]\bigr]={\operatorname{E}}[Y^2]-{\operatorname{E}}[m(X)^2]. \tag{a}$$ また ${\operatorname{E}}[m(X)]={\operatorname{E}}[Y]$(タワー性)なので$${\operatorname{V}}\bigl[m(X)\bigr]={\operatorname{E}}[m(X)^2]-({\operatorname{E}}[Y])^2. \tag{b}$$ (a)$+$(b) で ${\operatorname{E}}[m(X)^2]$ が消えて ${\operatorname{E}}[Y^2]-({\operatorname{E}}[Y])^2={\operatorname{V}}[Y]$.
□
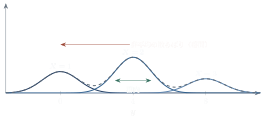
学年全体の点数のばらつき ${\operatorname{V}}[Y]$ は,
${\operatorname{E}}[{\operatorname{V}}[Y\mid X]]$:各クラスの中でのばらつきを平均したもの(群内変動)
${\operatorname{V}}[{\operatorname{E}}[Y\mid X]]$:クラス平均どうしのばらつき(群間変動)
の和になります.図3.4のように,全体の散らばりは「各群の中の散らばり」と「群の中心どうしの散らばり」に分けられます.第20章の分散分析はこの分解そのものであり,第16章の決定係数 $R^2$ も「${\operatorname{V}}[{\operatorname{E}}[Y\mid X]]/{\operatorname{V}}[Y]$(説明できる割合)」と同じ発想です.
$P\sim\mathrm{U}(0,1)$ とし,$P=p$ のもとで $Y\sim\mathrm{Bin}(10,p)$ とする.${\operatorname{E}}[Y]$ と ${\operatorname{V}}[Y]$ を求めよ.
解 ${\operatorname{E}}[Y\mid P]=10P$,${\operatorname{V}}[Y\mid P]=10P(1-P)$.${\operatorname{E}}[P]=\frac12$,${\operatorname{E}}[P^2]=\frac13$,${\operatorname{V}}[P]=\frac1{12}$.$${\operatorname{E}}[Y]={\operatorname{E}}[10P]=5.$$ $${\operatorname{V}}[Y]={\operatorname{E}}[10P(1-P)]+{\operatorname{V}}[10P]=10\Bigl(\frac12-\frac13\Bigr)+100\cdot\frac1{12}=\frac{5}{3}+\frac{25}{3}=10.$$ もし成功確率が $0.5$ に固定されていれば ${\operatorname{V}}[Y]=2.5$ ですが,成功確率自体のばらつき(群間の項 $25/3$)のせいで分散が4倍になります.このような現象を過分散といい,第18章のポアソン回帰などで問題になります.
$(X,Y)$ が $0<y<x<1$ 上の一様分布(密度2)に従うとき,${\operatorname{E}}[Y\mid X]$,${\operatorname{V}}[Y\mid X]$ を求め,分散の分解を確かめよ.
解 $f_X(x)=2x$,$f_{Y\mid X}(y\mid x)=\frac{2}{2x}=\frac1x\ (0<y<x)$.すなわち $X=x$ のもとで $Y\sim\mathrm{U}(0,x)$ なので$${\operatorname{E}}[Y\mid X]=\frac X2,\qquad{\operatorname{V}}[Y\mid X]=\frac{X^2}{12}.$$ ${\operatorname{E}}[X]=\int_0^12x^2\,\mathrm{d}x=\frac23$,${\operatorname{E}}[X^2]=\int_0^12x^3\,\mathrm{d}x=\frac12$,${\operatorname{V}}[X]=\frac12-\frac49=\frac1{18}$.$${\operatorname{E}}\bigl[{\operatorname{V}}[Y\mid X]\bigr]=\frac{1}{12}\cdot\frac12=\frac1{24},\qquad{\operatorname{V}}\bigl[{\operatorname{E}}[Y\mid X]\bigr]=\frac14\cdot\frac1{18}=\frac1{72}.$$ 和は $\frac1{24}+\frac1{72}=\frac4{72}=\frac1{18}$.一方,直接 $f_Y(y)=2(1-y)$ から ${\operatorname{E}}[Y]=\frac13$,${\operatorname{E}}[Y^2]=\frac16$,${\operatorname{V}}[Y]=\frac16-\frac19=\frac1{18}$.一致しました.
$X$ を見て $Y$ を予測するとき,予測の2乗誤差 ${\operatorname{E}}[(Y-g(X))^2]$ を最小にする関数は $g(X)={\operatorname{E}}[Y\mid X]$ です.これは前節の「定数での予測なら平均が最良」を,$X$ の値ごとに適用したものです.回帰分析(第16章)は,この ${\operatorname{E}}[Y\mid X]$ を直線などで近似する方法だと言えます.
3.3特性値の性質◆合格基盤
単位を変える(摂氏→華氏,円→千円)と,特性値はどう変わるでしょうか.答えは特性値の「種類」で決まります.位置を表すもの(平均・中央値・分位点)はデータと一緒に動き,ばらつきを表すもの(分散・標準偏差)は尺度の倍率だけで決まり,平行移動の影響を受けません.形を表すもの(歪度・尖度)と相関係数は,標準化した量から作られているので単位によらず,変わるとしても符号だけです.
3.3.1線形変換で特性値はどう変わるか
$Y=aX+b$($a\neq0$)と変換すると,特性値は具体的に次のように変わります.
| 特性値 | $Y=aX+b$ での値 | 理由 |
|---|---|---|
| 平均・中央値・最頻値・分位点 | $a\cdot(\text{元の値})+b$ | 位置は一緒に動く($a<0$ なら分位点の向きが反転) |
| 分散 | $a^2{\operatorname{V}}[X]$ | 平行移動は無関係,尺度は2乗で効く |
| 標準偏差 | $|a|\sigma_X$ | 分散の平方根 |
| 歪度 | ${\operatorname{sgn}}(a)\,\beta_1$ | 標準化で尺度が消え,符号だけ残る |
| 尖度 | $\beta_2$ | 4乗なので符号も消える |
| 共分散 ${\operatorname{Cov}}[aX+b,cY+d]$ | $ac{\operatorname{Cov}}[X,Y]$ | 双線形性 |
| 相関係数 ${\operatorname{Corr}}[aX+b,cY+d]$ | ${\operatorname{sgn}}(ac)\,\rho_{XY}$ | 単位によらない |
歪度・相関係数の場合到達度:理解 $Y=aX+b$ なら $Y-\mu_Y=a(X-\mu_X)$,$\sigma_Y=|a|\sigma_X$ なので$$\frac{Y-\mu_Y}{\sigma_Y}=\frac{a}{|a|}\cdot\frac{X-\mu_X}{\sigma_X}={\operatorname{sgn}}(a)\,\frac{X-\mu_X}{\sigma_X}.$$ これを3乗して期待値をとると ${\operatorname{sgn}}(a)^3\beta_1={\operatorname{sgn}}(a)\beta_1$,4乗なら $\beta_2$.相関係数は$\dfrac{ac{\operatorname{Cov}}[X,Y]}{|a|\sigma_X|c|\sigma_Y}={\operatorname{sgn}}(ac)\rho_{XY}$.
□
気温 $X$(摂氏)の平均が $20$,標準偏差が $5$,売上 $Y$ との相関係数が $0.6$,歪度が $-0.4$ であった.華氏 $F=1.8X+32$ に変換したときの平均・標準偏差・歪度・$Y$ との相関係数は?
解 平均 $1.8\times20+32=68$,標準偏差 $1.8\times5=9$,歪度 $-0.4$($a>0$ なので不変),相関係数 $0.6$(不変).
3.3.2共分散の双線形性
${\operatorname{Cov}}[X,X]={\operatorname{V}}[X]$,${\operatorname{Cov}}[X,Y]={\operatorname{Cov}}[Y,X]$.
双線形性:${\operatorname{Cov}}\Bigl[\sum_i a_iX_i,\ \sum_j b_jY_j\Bigr]=\sum_i\sum_j a_ib_j{\operatorname{Cov}}[X_i,Y_j]$.
定数 $c$ に対し ${\operatorname{Cov}}[X,c]=0$.
双線形性は「かっこの展開」と同じ感覚で使えます.たとえば$${\operatorname{V}}[aX+bY]={\operatorname{Cov}}[aX+bY,aX+bY]=a^2{\operatorname{V}}[X]+2ab{\operatorname{Cov}}[X,Y]+b^2{\operatorname{V}}[Y].$$ 3.5節ではこれを行列でまとめて書きます.
3.3.3コーシー=シュワルツの不等式と $|\rho|\le1$
${\operatorname{E}}[X^2]<\infty$,${\operatorname{E}}[Y^2]<\infty$ のとき$$\bigl({\operatorname{E}}[XY]\bigr)^2\le{\operatorname{E}}[X^2]\,{\operatorname{E}}[Y^2].$$ 等号は,ある定数 $t$ で $P(Y=tX)=1$(または $X=0$)となるときに限り成立する.
2次式の判別式を使う到達度:理解 任意の実数 $t$ について $(Y-tX)^2\ge0$ なので,その期待値も非負:$$g(t)={\operatorname{E}}[(Y-tX)^2]={\operatorname{E}}[X^2]\,t^2-2{\operatorname{E}}[XY]\,t+{\operatorname{E}}[Y^2]\ge0\quad(\text{すべての }t).$$ ${\operatorname{E}}[X^2]>0$ のとき,$g(t)$ は $t$ の2次関数で,常に0以上ということは,グラフが $t$ 軸と交わらない(接する)ので判別式が0以下:$$\frac{D}{4}=\bigl({\operatorname{E}}[XY]\bigr)^2-{\operatorname{E}}[X^2]{\operatorname{E}}[Y^2]\le0 .$$ 等号は $g(t)=0$ となる $t$ が存在するとき,すなわち ${\operatorname{E}}[(Y-tX)^2]=0$ で,これは $Y=tX$ が確率1で成り立つことを意味する.(${\operatorname{E}}[X^2]=0$ なら $X=0$ が確率1で,両辺0で成立.)
□
$0<{\operatorname{V}}[X]<\infty$,$0<{\operatorname{V}}[Y]<\infty$ のとき$$-1\le\rho_{XY}\le1 .$$ $|\rho_{XY}|=1$ となるのは,定数 $a\neq0,\ b$ で $Y=aX+b$ が確率1で成り立つときに限る($a>0$ なら $\rho=1$,$a<0$ なら $\rho=-1$).
相関係数の範囲の導出到達度:理解 コーシー=シュワルツの不等式を $X-\mu_X$ と $Y-\mu_Y$ に適用すると$$\bigl({\operatorname{Cov}}[X,Y]\bigr)^2=\bigl({\operatorname{E}}[(X-\mu_X)(Y-\mu_Y)]\bigr)^2\le{\operatorname{E}}[(X-\mu_X)^2]{\operatorname{E}}[(Y-\mu_Y)^2]={\operatorname{V}}[X]{\operatorname{V}}[Y].$$ 両辺を ${\operatorname{V}}[X]{\operatorname{V}}[Y]$ で割って $\rho_{XY}^2\le1$.等号条件は $Y-\mu_Y=t(X-\mu_X)$,すなわち $Y$ が $X$ の1次式.
□
$U=(X-\mu_X)/\sigma_X$,$W=(Y-\mu_Y)/\sigma_Y$ とおくと ${\operatorname{V}}[U]={\operatorname{V}}[W]=1$,${\operatorname{Cov}}[U,W]=\rho$.分散は非負なので$$0\le{\operatorname{V}}[U\pm W]=1+1\pm2\rho=2(1\pm\rho).$$ $+$ の方から $\rho\ge-1$,$-$ の方から $\rho\le1$.こちらの方が覚えやすいかもしれません.$\rho=1$ なら ${\operatorname{V}}[U-W]=0$ で $U=W$(完全な直線関係)です.
平均からの偏差 $X-\mu_X$,$Y-\mu_Y$ をベクトルと思い,${\operatorname{E}}[UV]$ を内積とみなすと,$\sigma_X,\sigma_Y$ はベクトルの長さ,${\operatorname{Cov}}$ は内積になり,$$\rho_{XY}=\frac{\text{内積}}{\text{長さ}\times\text{長さ}}=\cos\theta$$ と読めます.コーシー=シュワルツの不等式は「$|\cos\theta|\le1$」のことに他なりません.データの相関係数(3.4節)ではこの見方が文字どおり成り立ちます.
3.3.4チェビシェフの不等式
特性値の性質として,平均と分散だけから確率の上限が得られる不等式も重要です.
$X\ge0$ と $a>0$ に対し $P(X\ge a)\le\dfrac{{\operatorname{E}}[X]}{a}$(マルコフ).これを $(X-\mu)^2$ に適用して,分散 $\sigma^2$ が有限で正のとき,$k>0$ に対し$$P\bigl(|X-\mu|\ge k\sigma\bigr)\le\frac1{k^2}\quad(\text{チェビシェフ}).$$
マルコフ・チェビシェフの不等式の導出到達度:理解 $X\ge0$ なら $X\ge a\cdot\mathbb{1}(X\ge a)$($X\ge a$ なら右辺は $a\le X$,そうでなければ $0\le X$).期待値をとって ${\operatorname{E}}[X]\ge aP(X\ge a)$.チェビシェフは $P(|X-\mu|\ge k\sigma)=P((X-\mu)^2\ge k^2\sigma^2)\le\dfrac{{\operatorname{E}}[(X-\mu)^2]}{k^2\sigma^2}=\dfrac{1}{k^2}$.
□
どんな分布でも「平均から $2\sigma$ 以上離れる確率は $1/4$ 以下」です.正規分布なら実際は約 $0.046$ なので評価は粗いですが,分布を仮定しなくてよいのが強みで,第7章の大数の弱法則の証明に使われます.
ワークブックp.16〜17の「特性値の性質」では,線形変換での変化,共分散の性質,相関係数の範囲などが列挙されています.
「$|\rho|\le1$」はコーシー=シュワルツの不等式から出ます.証明の核心は「$t$ についての2次式が常に非負 $\Rightarrow$ 判別式 $\le0$」の一点です.
「無相関($\rho=0$)でも独立とは限らない」は第1章・第2章で具体例を見ました.逆に「独立 $\Rightarrow$ 無相関」は,${\operatorname{E}}[XY]={\operatorname{E}}[X]{\operatorname{E}}[Y]$(独立なら積の期待値が分かれる)から出ます.ただし2変量正規分布では無相関と独立が同値になります(第6章).
相関係数が「線形な関係の強さ」しか測らないことは,$|\rho|=1$ の等号条件(1次式)に表れています.
3.4データの特性値◆合格基盤
これまでは確率変数(母集団)の特性値でした.実際に手にするのはデータ $x_1,\dots,x_n$ なので,データから同じ種類の量を計算します.
3.4.1標本平均・標本分散・不偏分散
$$\begin{aligned} \text{標本平均}\quad&\bar x=\frac1n\sum_{i=1}^nx_i,\\ \text{標本分散}\quad&\hat\sigma^2=\frac1n\sum_{i=1}^n(x_i-\bar x)^2,\\ \text{不偏分散}\quad&s^2=\frac1{n-1}\sum_{i=1}^n(x_i-\bar x)^2 . \end{aligned}$$
$n$ で割るものと $n-1$ で割るもののどちらを「標本分散」と呼ぶかは文献によって異なります.ワークブックでは不偏分散を $s^2$($n-1$ で割る)で表すのが基本です.本書もワークブックに合わせ,$s^2$ は常に $n-1$ で割ったものとします.問題文の定義を必ず確認しましょう.
$$\sum_{i=1}^n(x_i-\bar x)^2=\sum_{i=1}^nx_i^2-n\bar x^2 .$$
偏差平方和の計算公式の導出到達度:導出 $\sum(x_i-\bar x)^2=\sum x_i^2-2\bar x\sum x_i+n\bar x^2=\sum x_i^2-2n\bar x^2+n\bar x^2$.($\sum x_i=n\bar x$ を使った.)
□
3.4.2なぜ $n-1$ で割るのか
$X_1,\dots,X_n$ が i.i.d. で ${\operatorname{E}}[X_i]=\mu$,${\operatorname{V}}[X_i]=\sigma^2$ のとき,$${\operatorname{E}}\Bigl[\sum_{i=1}^n(X_i-\bar X)^2\Bigr]=(n-1)\sigma^2,\qquad\text{したがって}\quad{\operatorname{E}}[s^2]=\sigma^2 .$$
不偏性の導出到達度:導出 $X_i-\bar X=(X_i-\mu)-(\bar X-\mu)$ と「真の平均からのずれ」に書き直します.$\sum(X_i-\mu)=n(\bar X-\mu)$ に注意して展開すると$$\sum_{i=1}^n(X_i-\bar X)^2=\sum_{i=1}^n(X_i-\mu)^2-2(\bar X-\mu)\cdot n(\bar X-\mu)+n(\bar X-\mu)^2=\sum_{i=1}^n(X_i-\mu)^2-n(\bar X-\mu)^2 .$$ 期待値をとると,${\operatorname{E}}[(X_i-\mu)^2]=\sigma^2$,${\operatorname{E}}[(\bar X-\mu)^2]={\operatorname{V}}[\bar X]=\sigma^2/n$(独立なので ${\operatorname{V}}[\bar X]=\frac{1}{n^2}\cdot n\sigma^2$)より$${\operatorname{E}}\Bigl[\sum(X_i-\bar X)^2\Bigr]=n\sigma^2-n\cdot\frac{\sigma^2}{n}=(n-1)\sigma^2 .$$
□
本当は真の平均 $\mu$ からの偏差を測りたいのですが,$\mu$ は分からないので $\bar x$ で代用します.ところが $\bar x$ はそのデータの偏差平方和を最小にする点です(前節のポイント:2乗誤差を最小にするのは平均).したがって $\sum(x_i-\bar x)^2\le\sum(x_i-\mu)^2$ で,偏差平方和は必ず小さめに出ます.そのぶんを補正するのが $n-1$ です.「$\bar x$ を計算するのにデータの自由度を1つ使ったので,残りは $n-1$」という自由度の考え方もこれと同じ内容です($n$ 個の偏差 $x_i-\bar x$ は和が0という制約を1本もつ).
3.4.3標本歪度・標本尖度・分位点
$m_r=\frac1n\sum_{i=1}^n(x_i-\bar x)^r$(標本の $r$ 次中心モーメント)として$$\text{標本歪度}\ b_1=\frac{m_3}{m_2^{3/2}},\qquad\text{標本尖度}\ b_2=\frac{m_4}{m_2^{2}}\quad(\text{または } b_2-3).$$
ソフトウェアによっては偏りを補正した別の式($n$ に依存する係数をかけたもの)を使うことがあります.試験では問題文で与えられた式に従いましょう.
データの分位点・四分位点も,並べ替えたデータから求めます.$n$ が偶数のときの中央値は中央2つの平均です.四分位点の計算方法は流儀がいくつかあり,値が少しずつ異なります(下の例ではその一つを示します).
データ $3,\,5,\,6,\,6,\,8,\,9,\,12,\,15$($n=8$)について,平均,中央値,最頻値,標本分散,不偏分散,標本歪度,標本尖度を求めよ.
解 $\sum x_i=64$ より $\bar x=8$.中央値は4番目と5番目の平均 $(6+8)/2=7$.最頻値は6.偏差 $x_i-8$:$-5,-3,-2,-2,0,1,4,7$.$$\sum(x_i-\bar x)^2=25+9+4+4+0+1+16+49=108 .$$ (検算:$\sum x_i^2=620$,$620-8\times64=108$.)標本分散 $m_2=108/8=13.5$,不偏分散 $s^2=108/7\approx15.43$.$$\sum(x_i-\bar x)^3=-125-27-8-8+0+1+64+343=240,\quad m_3=30,$$ $$\sum(x_i-\bar x)^4=625+81+16+16+0+1+256+2401=3396,\quad m_4=424.5 .$$ $$b_1=\frac{30}{13.5^{3/2}}\approx\frac{30}{49.60}\approx0.605\ (\text{右に歪んでいる}),\qquad b_2=\frac{424.5}{13.5^2}=\frac{424.5}{182.25}\approx2.33 .$$ 平均8 $>$ 中央値7 $>$ 最頻値6 と,右に裾の長い分布の典型的な並びです.
3.4.4標本共分散と標本相関係数
$$s_{xy}=\frac1{n-1}\sum_{i=1}^n(x_i-\bar x)(y_i-\bar y),\qquad r_{xy}=\frac{\sum(x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum(x_i-\bar x)^2}\sqrt{\sum(y_i-\bar y)^2}} .$$ $r_{xy}$ は分母・分子で割る数($n$ か $n-1$ か)が打ち消し合うので,どちらで定義しても同じ値になる.
偏差ベクトル ${\boldsymbol{u}}=(x_1-\bar x,\dots,x_n-\bar x)^\top$,${\boldsymbol{v}}=(y_1-\bar y,\dots,y_n-\bar y)^\top$ を考えると$$r_{xy}=\frac{{\boldsymbol{u}}^\top{\boldsymbol{v}}}{\|{\boldsymbol{u}}\|\,\|{\boldsymbol{v}}\|}=\cos\theta$$ で,前節のイメージが文字どおりに成り立ちます.$n$ 次元空間での2本の偏差ベクトルのなす角の余弦が相関係数です.
3.4.5グループをまとめたときの平均と分散
グループAは20人で平均5,標本分散($n$ で割る)4,グループBは30人で平均10,標本分散9である.全50人の平均と標本分散を求めよ.
解 全体平均 $\bar x=(20\times5+30\times10)/50=8$.分散の分解(データ版)を使うと$$\text{全体の分散}=\underbrace{\frac{20\times4+30\times9}{50}}_{\text{群内の平均}=7}+\underbrace{\frac{20(5-8)^2+30(10-8)^2}{50}}_{\text{群間}=6}=13 .$$ 「各グループの分散の平均」7だけでは足りず,グループの平均の違いによる6を足す必要があります.3.2節の分散の分解がデータでもそのまま成り立っています.
ワークブックp.17〜18の「データの特性値」では,確率変数の特性値に対応するデータ版の量が定義されています.
確率変数の ${\operatorname{E}}[\cdot]$ を,データの「$\frac1n\sum$」に置き換えたものが基本形です(分布をデータの経験分布で置き換える).不偏分散だけが $n-1$ で割る例外で,その理由は上で導出したとおりです.
標本歪度・標本尖度の分母は $m_2^{3/2}$,$m_2^2$ で,$n$ で割った標本分散 $m_2$ を使います.不偏分散 $s^2$ を使う定義もあるので,問題文の式を確認しましょう.
標本相関係数は $n$ と $n-1$ の違いの影響を受けない点を覚えておくと,計算の手間が省けます.
3.5平均ベクトルと分散共分散行列◆合格基盤
変数が3つ,4つと増えると,平均・分散・共分散を1つずつ書くのは大変です.そこでベクトルと行列でまとめて書きます.この表記は第16章の重回帰分析($\hat{\boldsymbol{\beta}}=(X^\top X)^{-1}X^\top{\boldsymbol{y}}$),第22章の主成分分析(分散共分散行列の固有値問題)など,準1級後半の内容を読むための必須の道具です.
3.5.1線形代数の補足
$m\times n$ 行列 $A=(a_{ij})$ と $n\times p$ 行列 $B=(b_{jk})$ の積 $AB$ は $m\times p$ 行列で,$(i,k)$ 成分は $\sum_{j=1}^na_{ij}b_{jk}$($A$ の $i$ 行目と $B$ の $k$ 列目の内積).
転置 $A^\top$ は行と列を入れ替えた行列:$(A^\top)_{ij}=a_{ji}$.重要な性質は $(AB)^\top=B^\top A^\top$(順序が逆になる).
列ベクトル ${\boldsymbol{a}},{\boldsymbol{b}}$($n\times1$)について,${\boldsymbol{a}}^\top{\boldsymbol{b}}=\sum a_ib_i$ は $1\times1$(スカラー,内積),${\boldsymbol{a}}{\boldsymbol{b}}^\top$ は $n\times n$ 行列で $(i,j)$ 成分が $a_ib_j$(外積).
$A^\top=A$ のとき対称行列という.
対称行列 $\Sigma$ が,すべての ${\boldsymbol{a}}\neq{\boldsymbol{0}}$ で ${\boldsymbol{a}}^\top\Sigma{\boldsymbol{a}}\ge0$ を満たすとき半正定値,$>0$ なら正定値という.
${\boldsymbol{a}}=(1,2)^\top$ のとき,${\boldsymbol{a}}^\top{\boldsymbol{a}}$ と ${\boldsymbol{a}}{\boldsymbol{a}}^\top$ を求めよ.
解 ${\boldsymbol{a}}^\top{\boldsymbol{a}}=1+4=5$(スカラー).${\boldsymbol{a}}{\boldsymbol{a}}^\top=\begin{pmatrix}1\\2\end{pmatrix}(1\ \ 2)=\begin{pmatrix}1&2\\2&4\end{pmatrix}$($2\times2$ の対称行列).縦 $\times$ 横で行列,横 $\times$ 縦でスカラー,と覚えましょう.
3.5.2平均ベクトルと分散共分散行列の定義
確率ベクトル ${\boldsymbol{X}}=(X_1,\dots,X_p)^\top$ に対し,$${\boldsymbol{\mu}}={\operatorname{E}}[{\boldsymbol{X}}]=\begin{pmatrix}{\operatorname{E}}[X_1]\\ \vdots\\ {\operatorname{E}}[X_p]\end{pmatrix},\qquad {\boldsymbol{\Sigma}}={\operatorname{V}}[{\boldsymbol{X}}]={\operatorname{E}}\bigl[({\boldsymbol{X}}-{\boldsymbol{\mu}})({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top\bigr]$$ をそれぞれ平均ベクトル,分散共分散行列という.${\boldsymbol{\Sigma}}$ の $(i,j)$ 成分は $\sigma_{ij}={\operatorname{Cov}}[X_i,X_j]$,対角成分は $\sigma_{ii}={\operatorname{V}}[X_i]$.
$({\boldsymbol{X}}-{\boldsymbol{\mu}})({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top$ は「縦 $\times$ 横」の外積なので $p\times p$ 行列で,$(i,j)$ 成分は $(X_i-\mu_i)(X_j-\mu_j)$ です.その期待値をとれば $(i,j)$ 成分が ${\operatorname{Cov}}[X_i,X_j]$ になります.$p=2$ なら$${\boldsymbol{\Sigma}}=\begin{pmatrix}{\operatorname{V}}[X_1]&{\operatorname{Cov}}[X_1,X_2]\\ {\operatorname{Cov}}[X_2,X_1]&{\operatorname{V}}[X_2]\end{pmatrix}=\begin{pmatrix}\sigma_1^2&\rho\sigma_1\sigma_2\\ \rho\sigma_1\sigma_2&\sigma_2^2\end{pmatrix}.$$
${\boldsymbol{\Sigma}}$ は対称行列(${\operatorname{Cov}}[X_i,X_j]={\operatorname{Cov}}[X_j,X_i]$ より).
${\boldsymbol{\Sigma}}={\operatorname{E}}[{\boldsymbol{X}}{\boldsymbol{X}}^\top]-{\boldsymbol{\mu}}{\boldsymbol{\mu}}^\top$(1変数の ${\operatorname{V}}[X]={\operatorname{E}}[X^2]-\mu^2$ の行列版).
${\boldsymbol{\Sigma}}$ は半正定値:任意の定数ベクトル ${\boldsymbol{a}}$ に対し ${\boldsymbol{a}}^\top{\boldsymbol{\Sigma}}{\boldsymbol{a}}={\operatorname{V}}[{\boldsymbol{a}}^\top{\boldsymbol{X}}]\ge0$.
性質(3)は,次の定理の特別な場合です.
3.5.3線形変換の公式 ${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$
$A$ を $q\times p$ 定数行列,${\boldsymbol{b}}$ を $q$ 次元定数ベクトルとし,${\boldsymbol{Y}}=A{\boldsymbol{X}}+{\boldsymbol{b}}$ とする.このとき$${\operatorname{E}}[{\boldsymbol{Y}}]=A{\boldsymbol{\mu}}+{\boldsymbol{b}},\qquad{\operatorname{V}}[{\boldsymbol{Y}}]=A{\boldsymbol{\Sigma}}A^\top.$$ 特に ${\boldsymbol{a}}$ を $p$ 次元定数ベクトルとすると,${\operatorname{E}}[{\boldsymbol{a}}^\top{\boldsymbol{X}}]={\boldsymbol{a}}^\top{\boldsymbol{\mu}}$,${\operatorname{V}}[{\boldsymbol{a}}^\top{\boldsymbol{X}}]={\boldsymbol{a}}^\top{\boldsymbol{\Sigma}}{\boldsymbol{a}}$.
線形変換の平均と分散の導出到達度:導出 平均:${\boldsymbol{Y}}$ の第 $k$ 成分は $Y_k=\sum_ja_{kj}X_j+b_k$ なので,期待値の線形性より ${\operatorname{E}}[Y_k]=\sum_ja_{kj}\mu_j+b_k$.これを並べたものが $A{\boldsymbol{\mu}}+{\boldsymbol{b}}$.
分散:${\boldsymbol{Y}}-{\operatorname{E}}[{\boldsymbol{Y}}]=A{\boldsymbol{X}}+{\boldsymbol{b}}-(A{\boldsymbol{\mu}}+{\boldsymbol{b}})=A({\boldsymbol{X}}-{\boldsymbol{\mu}})$.転置の性質 $(AB)^\top=B^\top A^\top$ より $\{A({\boldsymbol{X}}-{\boldsymbol{\mu}})\}^\top=({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top A^\top$.よって$${\operatorname{V}}[{\boldsymbol{Y}}]={\operatorname{E}}\bigl[A({\boldsymbol{X}}-{\boldsymbol{\mu}})({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top A^\top\bigr]=A\,{\operatorname{E}}\bigl[({\boldsymbol{X}}-{\boldsymbol{\mu}})({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top\bigr]A^\top=A{\boldsymbol{\Sigma}}A^\top.$$ 途中で定数行列 $A$,$A^\top$ を期待値の外に出しました.これは各成分が $\sum a_{kj}(\cdots)a_{lm}$ という定数倍の和なので,期待値の線形性から許されます.
□
1変数では ${\operatorname{V}}[aX]=a^2{\operatorname{V}}[X]=a\cdot{\operatorname{V}}[X]\cdot a$ でした.行列では掛ける順序が大事なので,$a^2$ を「左から $A$,右から $A^\top$」で挟む形に書きます.サイズを確認すると $(q\times p)(p\times p)(p\times q)=q\times q$ で,ちゃんと ${\boldsymbol{Y}}$($q$ 次元)の分散共分散行列のサイズになっています.サイズが合うように転置を置くと覚えれば,$A^\top{\boldsymbol{\Sigma}}A$ と間違えることはありません.
${\boldsymbol{X}}=(X_1,X_2)^\top$ の分散共分散行列が ${\boldsymbol{\Sigma}}=\begin{pmatrix}4&2\\2&9\end{pmatrix}$ のとき,$Y_1=X_1+X_2$,$Y_2=X_1-X_2$ の分散共分散行列を求めよ.
解 $A=\begin{pmatrix}1&1\\1&-1\end{pmatrix}$ とおくと ${\boldsymbol{Y}}=A{\boldsymbol{X}}$.$$A{\boldsymbol{\Sigma}}=\begin{pmatrix}1&1\\1&-1\end{pmatrix}\begin{pmatrix}4&2\\2&9\end{pmatrix}=\begin{pmatrix}6&11\\2&-7\end{pmatrix},$$ $$A{\boldsymbol{\Sigma}}A^\top=\begin{pmatrix}6&11\\2&-7\end{pmatrix}\begin{pmatrix}1&1\\1&-1\end{pmatrix}=\begin{pmatrix}17&-5\\-5&9\end{pmatrix}.$$ よって ${\operatorname{V}}[Y_1]=17$,${\operatorname{V}}[Y_2]=9$,${\operatorname{Cov}}[Y_1,Y_2]=-5$.成分で検算すると ${\operatorname{V}}[X_1+X_2]=4+9+2\cdot2=17$,${\operatorname{V}}[X_1-X_2]=4+9-4=9$,${\operatorname{Cov}}[X_1+X_2,X_1-X_2]={\operatorname{V}}[X_1]-{\operatorname{V}}[X_2]=4-9=-5$.一致します.
${\boldsymbol{\Sigma}}=\begin{pmatrix}4&1&0\\1&2&-1\\0&-1&3\end{pmatrix}$ のとき,$U=X_1+X_2+X_3$,$W=X_1-2X_3$ の分散と相関係数を求めよ.
解 $A=\begin{pmatrix}1&1&1\\1&0&-2\end{pmatrix}$($2\times3$).$$A{\boldsymbol{\Sigma}}=\begin{pmatrix}5&2&2\\4&3&-6\end{pmatrix},\qquad A{\boldsymbol{\Sigma}}A^\top=\begin{pmatrix}5+2+2&5-4\\4+3-6&4+12\end{pmatrix}=\begin{pmatrix}9&1\\1&16\end{pmatrix}.$$ ${\operatorname{V}}[U]=9$,${\operatorname{V}}[W]=16$,${\operatorname{Cov}}[U,W]=1$,${\operatorname{Corr}}[U,W]=\dfrac{1}{3\times4}=\dfrac1{12}\approx0.083$.
${\boldsymbol{a}}^\top{\boldsymbol{\Sigma}}{\boldsymbol{a}}=\sum_i\sum_ja_ia_j\sigma_{ij}$ で,これは第1章の$${\operatorname{V}}\Bigl[\sum a_iX_i\Bigr]=\sum a_i^2{\operatorname{V}}[X_i]+2\sum_{i<j}a_ia_j{\operatorname{Cov}}[X_i,X_j]$$ を行列で一行に書いたものです.${\boldsymbol{\Sigma}}$ の対角成分が分散の項,非対角成分(対称に2回現れる)が共分散の項に対応します.
3.5.42次形式の期待値◇満点補強
$A$ を $p\times p$ 定数行列とすると,$${\operatorname{E}}[{\boldsymbol{X}}^\top A{\boldsymbol{X}}]={\operatorname{tr}}(A{\boldsymbol{\Sigma}})+{\boldsymbol{\mu}}^\top A{\boldsymbol{\mu}}.$$
2次形式の期待値の導出到達度:参照 ${\boldsymbol{X}}^\top A{\boldsymbol{X}}$ はスカラーなので,トレース(対角成分の和)をとっても変わらない.トレースの性質 ${\operatorname{tr}}(BC)={\operatorname{tr}}(CB)$ を使うと$${\boldsymbol{X}}^\top A{\boldsymbol{X}}={\operatorname{tr}}({\boldsymbol{X}}^\top A{\boldsymbol{X}})={\operatorname{tr}}(A{\boldsymbol{X}}{\boldsymbol{X}}^\top).$$ 期待値とトレースは交換できる(どちらも線形)ので,性質(2) ${\operatorname{E}}[{\boldsymbol{X}}{\boldsymbol{X}}^\top]={\boldsymbol{\Sigma}}+{\boldsymbol{\mu}}{\boldsymbol{\mu}}^\top$ を使って$${\operatorname{E}}[{\boldsymbol{X}}^\top A{\boldsymbol{X}}]={\operatorname{tr}}\bigl(A({\boldsymbol{\Sigma}}+{\boldsymbol{\mu}}{\boldsymbol{\mu}}^\top)\bigr)={\operatorname{tr}}(A{\boldsymbol{\Sigma}})+{\operatorname{tr}}(A{\boldsymbol{\mu}}{\boldsymbol{\mu}}^\top)={\operatorname{tr}}(A{\boldsymbol{\Sigma}})+{\boldsymbol{\mu}}^\top A{\boldsymbol{\mu}}.$$
□
$A=I$(単位行列)なら ${\operatorname{E}}[\sum X_i^2]=\sum\sigma_{ii}+\sum\mu_i^2$ で,1変数の ${\operatorname{E}}[X^2]=\sigma^2+\mu^2$ の和です.この公式は第16章で残差平方和の期待値 ${\operatorname{E}}[S_e]=(n-p-1)\sigma^2$ を示すときに使います.
3.5.5相関行列◇満点補強
$D={\operatorname{diag}}(\sigma_1,\dots,\sigma_p)$(標準偏差を対角に並べた行列)とするとき,$$R=D^{-1}{\boldsymbol{\Sigma}}D^{-1}$$ を相関行列という.$(i,j)$ 成分は $\sigma_{ij}/(\sigma_i\sigma_j)=\rho_{ij}$,対角成分は1.
$D^{-1}{\boldsymbol{\Sigma}}D^{-1}$ は「${\boldsymbol{\Sigma}}$ の $i$ 行目を $\sigma_i$ で割り,$j$ 列目を $\sigma_j$ で割る」操作です.これは標準化した変数 $Z_i=(X_i-\mu_i)/\sigma_i$ の分散共分散行列にほかならず,定理3.11で $A=D^{-1}$ とした場合に当たります.
対角成分が1で非対角成分が $[-1,1]$ に入っていても,相関行列になるとは限りません.相関行列は半正定値でなければならないからです.たとえば3変数で $\rho_{12}=\rho_{23}=0.9$,$\rho_{13}=0$ は「$X_1$ と $X_2$ がほぼ同じ,$X_2$ と $X_3$ がほぼ同じなのに,$X_1$ と $X_3$ が無相関」という矛盾した状態で,実際にこの行列は負の固有値をもち(行列式が $1-0.81-0.81=-0.62<0$),相関行列になりません.
ワークブックp.18では,平均ベクトル・分散共分散行列と線形変換の公式が行列でまとめて書かれています.
${\operatorname{V}}[{\boldsymbol{X}}]={\operatorname{E}}[({\boldsymbol{X}}-{\boldsymbol{\mu}})({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top]$ の転置の位置に注意.$({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top({\boldsymbol{X}}-{\boldsymbol{\mu}})$ と逆にすると,スカラー $\sum(X_i-\mu_i)^2$ になってしまいます(期待値は分散の和 ${\operatorname{tr}}{\boldsymbol{\Sigma}}$).
${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$ の導出で使っているのは,(i) $A({\boldsymbol{X}}-{\boldsymbol{\mu}})$ の転置が $({\boldsymbol{X}}-{\boldsymbol{\mu}})^\top A^\top$ になること,(ii) 定数行列は期待値の外に出せること,の2点だけです.
公式を使う前に,$A$ の各行が「作りたい合成変数の係数」になっているか確認しましょう.$Y_1=X_1+X_2$ なら $A$ の1行目は $(1,1)$ です.
3.6例題に取り組むための考え方◆合格基盤
ワークブックp.18–20の例題では,本章の特性値の計算が総合的に問われます.
特性値を求めるタイプ:まず ${\operatorname{E}}[X],{\operatorname{E}}[X^2],{\operatorname{E}}[X^3],{\operatorname{E}}[X^4]$ を求め,中心モーメントの公式で $\mu_2,\mu_3,\mu_4$ に直す.積率母関数が分かっている分布なら,第2章の方法(微分または展開,キュムラント)が速い.
条件付き期待値・分散のタイプ:「条件付き分布が既知の分布(二項・ポアソン・一様など)になっていないか」を真っ先に見る.なっていれば,その分布の平均・分散の公式を使ってすぐに ${\operatorname{E}}[Y\mid X]$,${\operatorname{V}}[Y\mid X]$ が書ける.その後,繰り返し期待値の法則と分散の分解.
相関係数の範囲・等号条件のタイプ:$|\rho|\le1$ の証明の流れ(非負の2次式 $\to$ 判別式)を再現できるようにしておく.
行列のタイプ:係数行列 $A$ を正しく作り,$A{\boldsymbol{\Sigma}}A^\top$ を丁寧に計算.結果が対称行列になっていなければ計算ミス.成分での検算(和の分散の公式)も習慣にする.
分散の分解 ${\operatorname{V}}[Y]={\operatorname{E}}[{\operatorname{V}}[Y\mid X]]+{\operatorname{V}}[{\operatorname{E}}[Y\mid X]]$ は階層モデル(成功確率やポアソン平均がランダムな場合),ランダムな個数の和 $S=\sum_{i=1}^NX_i$(${\operatorname{V}}[S]={\operatorname{E}}[N]{\operatorname{V}}[X]+{\operatorname{V}}[N]({\operatorname{E}}[X])^2$)などでよく使います.
${\operatorname{V}}[{\boldsymbol{a}}^\top{\boldsymbol{X}}]={\boldsymbol{a}}^\top{\boldsymbol{\Sigma}}{\boldsymbol{a}}$ を使うポートフォリオの分散最小化(2資産の最適な配分)は典型問題です.
データの特性値は電卓(四則と $\sqrt{\ }$ が使える普通電卓)で計算させる数値入力問題になりやすいので,$\sum x_i^2-n\bar x^2$ などの計算公式で手際よく.$s^2$($n-1$)と $m_2$($n$)の取り違えに注意.
線形変換で歪度・尖度・相関係数が(符号を除き)不変であることは,選択肢の正誤判定でよく使われます.
この章の内容は,別冊の問題集 第3章(問3.1〜3.10)で演習できます.
平均・中央値・最頻値を「重心・面積の二等分点・山の頂上」として区別し,分布の歪みとの関係を説明できる.
原点まわりのモーメントから中心モーメント $\mu_2,\mu_3,\mu_4$ を計算し,歪度・尖度を求められる.
尖度の定義(3を引くか)が文献によって違うことを知っている.
共分散・相関係数を同時分布から計算できる.
${\operatorname{E}}[Y\mid X=x]$(数)と ${\operatorname{E}}[Y\mid X]$(確率変数)を区別し,WB p.16の誤植を正しく読める.
繰り返し期待値の法則と分散の分解を導出し,階層モデルやランダムな個数の和に使える.
線形変換での特性値の変化(歪度・相関の符号,尖度の不変性)を整理できる.
コーシー=シュワルツの不等式を判別式で証明し,$|\rho|\le1$ とその等号条件を説明できる.
不偏分散が $n-1$ で割る理由を式で示せる.データの歪度・尖度・相関係数を計算できる.
${\operatorname{V}}[A{\boldsymbol{X}}]=A{\boldsymbol{\Sigma}}A^\top$ を導出し,合成変数の分散・共分散を行列で計算できる.
分散共分散行列・相関行列が半正定値であることの意味を説明できる.
統計検定準1級 合格ナビ:統計検定準1級の学習アプリ。参考書33章と演習・模試あわせて374問を、解説つきでスマホ・パソコンのブラウザで。第1〜3章の問題と参考書は登録なしで無料。全章は1,980円の買い切り。
アプリを無料で開く有料版と無料版の違い