第2章 確率分布と母関数(統計検定準1級)
このページはプロモーション(広告)を含みます。
『統計学実践ワークブック』第2章に対応する参考書の本文です(無料公開)。この章の練習問題 10 問もあります。
累積分布関数(分布関数)の3つの性質(単調非減少・右連続・両端の極限)を,階段型・なめらか型・混在型のグラフと結びつけて理解する.
非負の確率変数について,生存関数を使った期待値の公式 ${\operatorname{E}}[X]=\int_0^\infty\{1-F(x)\}\,\mathrm{d}x$ を導出し,打ち切りのある量の期待値計算に使えるようにする.
同時分布から周辺分布・条件付き分布を作る操作を,「表の行和・列和」「密度の切り口の正規化」という図で理解し,独立性を正しく判定できるようにする.
確率母関数・積率母関数・特性関数・キュムラント母関数について,「なぜ分布が決まるのか」「なぜ微分でモーメントが出るのか」「なぜ独立な和は積になるのか」を自分の言葉で説明できるようにする.
| ワークブックの節 | WB頁 | 本書での扱い |
|---|---|---|
| 累積分布関数と生存関数 | p.7 | 2.1節(分布関数の性質,混在型の分布,生存関数と期待値の公式) |
| 同時確率密度関数 | p.7 | 2.2節(同時分布・周辺分布・条件付き分布,独立性の判定) |
| 母関数 | p.9 | 2.3節(確率母関数・積率母関数・特性関数・キュムラント母関数,和の分布) |
| 例題 | p.11 | 2.4節(例題に取り組むための考え方)(演習は問題集 第2章) |
◆合格基盤 まず読む:2.1節(分布関数の3性質,$<$ と $\le$ の区別,非負の確率変数での ${\operatorname{E}}[X]=\int_0^\infty P(X>x)\,\mathrm{d}x$),2.2節(周辺・条件付き分布,独立性の判定),2.3節の確率母関数・積率母関数と独立な和
◇満点補強 後から補う:2.1節の混在型の分布,2.3節の特性関数・キュムラント母関数・多変量の母関数
+背景・発展 初回は飛ばしてよい:右連続性の証明(確率の連続性),一意性定理の背景(ラプラス変換,モーメント問題)
前提:第1章(条件付き確率,期待値の線形性),微積分(部分積分,重積分の順序交換)
演習:◆ 問2.1〜問2.3,問2.5〜問2.7,問2.9,◇ 問2.4,問2.8,問2.10.到達確認は 問2.3,問2.9
第1章では,確率変数を確率関数や密度関数で表しました.ワークブック第2章は,分布を表す「別の顔」を一度に紹介する章です.累積分布関数,生存関数,そして母関数 ── どれも同じ分布を違う角度から写した写真のようなものです.ワークブックはこれを3〜4ページで一気に並べるため,「なぜわざわざ別の表し方をするのか」が見えにくくなっています.本章では,それぞれの表し方がどんな計算を楽にするための道具なのかを意識しながら進みます.特に母関数は,第5・6章の分布の性質(再生性など)や第7章の中心極限定理の証明の根幹になるので,ここでしっかり理解しておきましょう.
2.1累積分布関数と生存関数◆合格基盤
2.1.1累積分布関数 ── 「ここまでに入る確率」
確率変数 $X$ の分布を表す方法として,離散型なら確率関数 $p(x)$,連続型なら密度関数 $f(x)$ を使いました.しかし,この2つは性質の違うもので,離散と連続が混ざった量(後述)はどちらでも表せません.そこで,どんな確率変数にも使える共通の表し方として次の関数を考えます.
確率変数 $X$ に対し,$$F(x)=P(X\le x)\qquad(-\infty<x<\infty)$$ を $X$ の累積分布関数(cumulative distribution function, cdf),または単に分布関数という.
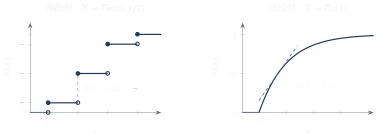
数直線上に確率の「砂」がまかれているとします.離散型なら砂は特定の点に山盛りに,連続型なら薄く広く積もっています.$F(x)$ は「左端から $x$ までにある砂の総量」です.$x$ を右へ動かしていくと,砂の量は増えるか変わらないかのどちらかで,最後には全部($=1$)になります.
離散型:砂の山を通過した瞬間に $F$ が跳ね上がる(階段状).跳びの高さがその点の確率 $p(x)$.
連続型:砂は薄く広がっているので $F$ はなめらかに増える.増え方の速さ(傾き)が密度 $f(x)$.
2.1.2累積分布関数の3つの性質
累積分布関数 $F$ は次の3つの性質をもつ.
単調非減少:$x<y$ ならば $F(x)\le F(y)$.
右連続:各点 $a$ で $\displaystyle\lim_{x\downarrow a}F(x)=F(a)$.
両端の極限:$\displaystyle\lim_{x\to-\infty}F(x)=0$,$\displaystyle\lim_{x\to\infty}F(x)=1$.
逆に,この3つを満たす関数 $F$ は,何らかの確率変数の累積分布関数になっている.
最後の「逆に」の部分が重要で,この3条件が「分布関数であること」の判定基準になります.準1級では「次の関数のうち分布関数になり得るものはどれか」という形でも問われます.
性質の導出到達度:理解 (1) $x<y$ なら事象として $\{X\le x\}\subset\{X\le y\}$ なので,第1章の確率の基本性質(包含関係なら確率は小さい)から $F(x)\le F(y)$.
(2) $x_n\downarrow a$(上から $a$ に近づく数列)をとると,事象 $A_n=\{X\le x_n\}$ は $A_1\supset A_2\supset\cdots$ と縮んでいき,その共通部分は$$\bigcap_{n=1}^\infty\{X\le x_n\}=\{X\le a\}$$ です($X\le x_n$ がすべての $n$ で成り立つことと $X\le a$ は同じ).確率の公理3から導かれる確率の連続性「縮んでいく事象列の確率は,共通部分の確率に収束する」を使うと,$F(x_n)=P(A_n)\to P(X\le a)=F(a)$.
(3) $x_n\uparrow\infty$ なら $\{X\le x_n\}$ は広がっていき,和集合は $\Omega$ 全体なので $F(x_n)\to P(\Omega)=1$.$x_n\downarrow-\infty$ なら縮んでいき共通部分は $\varnothing$ なので $F(x_n)\to 0$.
□
$F(a)=P(X\le a)$ は「$a$ ちょうど」を含む確率です.右から $a$ に近づくと,$\{X\le x\}$ は常に点 $a$ を含んだまま縮むので,極限でも点 $a$ の確率が残り,ちゃんと $F(a)$ に一致します.
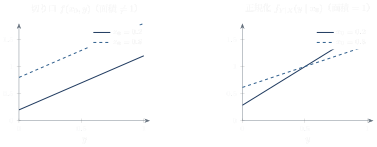
一方,左から近づくと $\{X\le x\}$($x<a$)はどれも点 $a$ を含まないので,極限は $P(X<a)$ にしかなりません.点 $a$ に確率の山があれば,その分だけ $F(a)$ とずれます.図2.1左で,黒丸が段の上側(右側の線の左端)にあるのはこのためです.
右連続性から,次の便利な公式が導けます.左極限を $F(a-)=\lim_{x\uparrow a}F(x)$ と書きます.
$$\begin{aligned} P(a<X\le b)&=F(b)-F(a), & P(X>a)&=1-F(a),\\ P(X<a)&=F(a-), & P(X=a)&=F(a)-F(a-)\ (\text{点 \(a\) での跳びの高さ}). \end{aligned}$$ 連続型なら跳びはなく $P(X=a)=0$ なので,$<$ と $\le$ の区別は不要になる.
離散型では $P(X<3)$ と $P(X\le3)$ は違います.たとえば $X\sim\mathrm{Bin}(3,1/2)$ なら $P(X\le 1)=F(1)=1/2$ ですが $P(X<1)=F(1-)=1/8$ です.試験では「以上」「より大きい」の読み違いが典型的な失点源です.$P(X\ge a)=1-P(X<a)=1-F(a-)$ であり,$1-F(a)$ ではないことに注意しましょう.
2.1.3密度関数との関係
連続型では,$$F(x)=\int_{-\infty}^{x}f(t)\,\mathrm{d}t,\qquad f(x)=\frac{\mathrm d}{\mathrm dx}F(x)\quad(\text{\(f\) が連続な点で})$$ という関係があります(微積分学の基本定理).実用上は「$F$ を微分すれば密度」「密度を積分すれば $F$」と覚えておけば十分です.第4章の変数変換では,まず $Y=g(X)$ の分布関数 $P(Y\le y)$ を求めてから微分する,という方法(分布関数法)をよく使います.
$X$ の分布関数が $F(x)=0\ (x<0)$,$F(x)=x^2\ (0\le x<1)$,$F(x)=1\ (x\ge 1)$ で与えられている.$P(0.3<X\le0.6)$,密度関数 $f(x)$,$P(X\le m)=1/2$ となる $m$(中央値)を求めよ.
解 $P(0.3<X\le0.6)=F(0.6)-F(0.3)=0.36-0.09=0.27$.$0<x<1$ で $f(x)=F'(x)=2x$,それ以外で $0$.$m^2=1/2$ より $m=1/\sqrt2\approx0.707$.まず3条件を確認しておくと,$x^2$ は $[0,1]$ で増加,$x=0,1$ でつながっており(連続なので当然右連続),両端で0と1になっています.
2.1.4離散と連続が混ざった分布
現実には,離散型とも連続型とも言えない量があります.
ある保険で,1年間に保険金請求がない確率は $0.7$ である.請求がある場合の支払額(万円)は平均10の指数分布に従う.支払額 $X$ の分布関数を求め,$P(X\le5)$ と ${\operatorname{E}}[X]$ を求めよ.
解 $X=0$ となる確率が $0.7$ あり,それ以外は連続的に分布します.$x\ge0$ では,全確率の公式により$$F(x)=P(X\le x)=0.7\times1+0.3\times\bigl(1-e^{-x/10}\bigr),$$ $x<0$ では $F(x)=0$.したがって $F$ は $x=0$ で高さ $0.7$ だけ跳び,その後なめらかに増えます(図2.2).$$P(X\le5)=0.7+0.3(1-e^{-0.5})\approx0.7+0.3\times0.3935=0.818.$$ 期待値は「請求なし」と「請求あり」に分けて ${\operatorname{E}}[X]=0.7\times0+0.3\times10=3$(万円).
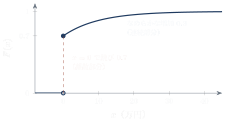
混在型の分布は,確率関数でも密度関数でも一つの式で表せませんが,分布関数なら問題なく表せます.計算では「離散部分(跳び)」と「連続部分(密度)」に分けて,期待値なら ${\operatorname{E}}[X]=\sum(\text{点}\times\text{跳び})+\int x\,f_c(x)\,\mathrm{d}x$($f_c$ は連続部分の密度)と足し合わせます.第19章のトービットモデル($0$ で打ち切られる応答)や生存時間解析の打ち切りは,まさにこの形です.
2.1.5生存関数
$$S(x)=1-F(x)=P(X>x)$$ を生存関数(survival function)という.
$X$ を製品の寿命や患者の生存時間と考えると,$S(x)$ は「時刻 $x$ の時点でまだ生きている(壊れていない)確率」です.名前の由来はここにあります.$S$ は $F$ を上下ひっくり返したものなので,単調非増加・右連続で,$S(-\infty)=1$,$S(\infty)=0$ です.
$X\sim\mathrm{Ex}(\lambda)$(密度 $\lambda e^{-\lambda x},\ x>0$)なら $S(x)=e^{-\lambda x}$.このとき$$P(X>s+t\mid X>s)=\frac{P(X>s+t)}{P(X>s)}=\frac{e^{-\lambda(s+t)}}{e^{-\lambda s}}=e^{-\lambda t}=P(X>t).$$ 「$s$ 時間生き延びた」という条件のもとで,さらに $t$ 時間生き延びる確率は,新品が $t$ 時間生き延びる確率と同じです(無記憶性).生存関数を使うと,このような条件付き確率がすっきり書けます.
生存関数は第19章の生存時間解析で主役になります.そこで登場するハザード関数 $h(x)=f(x)/S(x)$ は「$x$ まで生きた人が次の瞬間に死ぬ率」で,指数分布では $h(x)=\lambda$(一定)となります.
2.1.6生存関数で期待値を求める
非負の確率変数については,生存関数を積分すると期待値になるという,とても便利な公式があります.
$X\ge0$ のとき,$${\operatorname{E}}[X]=\int_0^\infty S(x)\,\mathrm{d}x=\int_0^\infty P(X>x)\,\mathrm{d}x .$$ $X$ が $0,1,2,\dots$ に値をとる離散型なら$${\operatorname{E}}[X]=\sum_{k=1}^\infty P(X\ge k)=\sum_{k=0}^\infty P(X>k).$$
連続型の場合到達度:導出 $X\ge 0$ なら $X=\int_0^X 1\,\mathrm{d}x=\int_0^\infty \mathbb{1}(x<X)\,\mathrm{d}x$ と書けます($\mathbb{1}(\cdot)$ はかっこ内が正しければ1,そうでなければ0).両辺の期待値をとり,期待値と積分の順序を交換すると(非負なので交換してよい)$${\operatorname{E}}[X]=\int_0^\infty {\operatorname{E}}[\mathbb{1}(x<X)]\,\mathrm{d}x=\int_0^\infty P(X>x)\,\mathrm{d}x .$$ 密度を使って確かめることもできます.${\operatorname{E}}[X]=\int_0^\infty t f(t)\,\mathrm{d}t=\int_0^\infty\Bigl(\int_0^t\,\mathrm{d}x\Bigr)f(t)\,\mathrm{d}t$ の積分順序を交換すると,$0<x<t<\infty$ の領域を「$x$ を固定して $t$ を $x$ から $\infty$ まで」と見直して$$\int_0^\infty\Bigl(\int_x^\infty f(t)\,\mathrm{d}t\Bigr)\,\mathrm{d}x=\int_0^\infty S(x)\,\mathrm{d}x .$$ 離散型も同様に,$X=\sum_{k=1}^\infty\mathbb{1}(X\ge k)$($X=3$ なら $k=1,2,3$ の3項が1)の期待値をとればよい.
□
この公式は $X\ge0$ が前提です.たとえば $X\sim\mathrm{U}(-1,1)$ では $\int_0^\infty P(X>x)\,\mathrm{d}x=\int_0^1\frac{1-x}{2}\,\mathrm{d}x=\frac14$ ですが,${\operatorname{E}}[X]=0$ です.負の値もとる場合は,負の部分を別に引いて$${\operatorname{E}}[X]=\int_0^\infty P(X>x)\,\mathrm{d}x-\int_{-\infty}^0 P(X<x)\,\mathrm{d}x$$ とします(上の例では $\frac14-\frac14=0$).また,$X=\min(T,c)$ のように上限で打ち切った量は非負なら公式がそのまま使えますが,「$T\le c$ の場合だけを集めた」切断された量(条件付き分布)とは別物です.両者を混同しないようにしましょう.
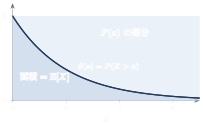
100人の寿命を考え,時刻 $x$ で生き残っている割合 $S(x)$ のグラフを描きます.各時刻の生存者数を時間方向に積み上げると「全員の生きた時間の合計」になり,それを人数で割ったものが平均寿命です.図2.3の色付き部分の面積がちょうど平均になっています.
部品の寿命 $T$ が平均2年の指数分布に従い,3年経つと故障していなくても交換する.実際の使用期間 $X=\min(T,3)$ の期待値を求めよ.
解 $X\ge0$ で,$x<3$ なら $P(X>x)=P(T>x)=e^{-x/2}$,$x\ge3$ なら $P(X>x)=0$.定理2.3より$${\operatorname{E}}[X]=\int_0^3 e^{-x/2}\,\mathrm{d}x=\Bigl[-2e^{-x/2}\Bigr]_0^3=2(1-e^{-1.5})\approx1.554\ (\text{年}).$$ $X$ は $x=3$ に確率 $P(T>3)=e^{-1.5}\approx0.223$ の跳びをもつ混在型ですが,生存関数を使えば場合分けせずに計算できます.
成功確率 $p$ の試行を成功するまで繰り返すとき,それまでの失敗回数 $X$ の期待値を求めよ.
解 $X\ge k$ は「最初の $k$ 回がすべて失敗」なので $P(X\ge k)=(1-p)^k$.$${\operatorname{E}}[X]=\sum_{k=1}^\infty(1-p)^k=\frac{1-p}{1-(1-p)}=\frac{1-p}{p}.$$ 確率関数 $p(1-p)^k$ に $k$ をかけて足す計算(微分を使う)より,ずっと簡単です.$p=1/4$ なら ${\operatorname{E}}[X]=3$.
ワークブックp.7では,分布関数・生存関数の定義と基本的な性質が数行で述べられています.読むときは次の点を補ってください.
「右連続」は,定義 $F(x)=P(X\le x)$ の等号付き不等号から来ている(本書の上のイメージ参照).$P(X<x)$ で定義する流儀では左連続になるので,他書と比べるときは定義を確認する.
生存関数 $S(x)=P(X>x)$ は不等号に等号を含まない.このため $S(x)=1-F(x)$ がちょうど成り立つ.
連続型では「$F$ を微分すると $f$」,「$S$ を微分すると $-f$」.符号に注意.
2.2同時確率分布◆合格基盤
2.2.12つの確率変数を同時に見る
身長と体重,気温と売上のように,2つの量の関係を調べたいときは,それぞれの分布を別々に見るだけでは足りません.「身長が高い人は体重も重い傾向がある」といった組合せの情報は,2つを同時に見たときにしか現れないからです.そこで $(X,Y)$ の組の分布(同時分布)を考えます.
離散型:$p(x,y)=P(X=x,\,Y=y)$ を同時確率関数という.$\sum_x\sum_y p(x,y)=1$.
連続型:任意の領域 $A$ に対し $P\bigl((X,Y)\in A\bigr)=\iint_A f(x,y)\,\mathrm{d}x\,\mathrm{d}y$ となる $f(x,y)\ge0$ を同時確率密度関数という.$\iint f(x,y)\,\mathrm{d}x\,\mathrm{d}y=1$.
また $F(x,y)=P(X\le x,\,Y\le y)$ を同時分布関数という.連続型では $f(x,y)=\dfrac{\partial^2F(x,y)}{\partial x\,\partial y}$.
1変数の密度は「グラフの下の面積が確率」でした.2変数では,$xy$ 平面の上に $f(x,y)$ の高さをもつ山(地形)を考え,領域 $A$ の上にある山の体積が $P((X,Y)\in A)$ です.山全体の体積は1です.
2.2.2周辺分布 ── 片方を「潰す」
同時分布から,$X$ だけの分布を取り出したものを周辺分布といいます.
$$p_X(x)=\sum_y p(x,y),\qquad f_X(x)=\int_{-\infty}^{\infty}f(x,y)\,\mathrm{d}y .$$ $Y$ についても同様.
$(X,Y)$ の同時確率関数が次の表で与えられている.
| $Y=0$ | $Y=1$ | $Y=2$ | $p_X(x)$ | |
|---|---|---|---|---|
| $X=0$ | 0.10 | 0.20 | 0.10 | 0.40 |
| $X=1$ | 0.20 | 0.30 | 0.10 | 0.60 |
| $p_Y(y)$ | 0.30 | 0.50 | 0.20 | 1 |
周辺分布,$X=0$ のときの $Y$ の条件付き分布を求めよ.
解 周辺分布は行和・列和です(表の余白 margin に書くので「周辺」marginal と呼びます).$p_X(0)=0.4$,$p_X(1)=0.6$,$p_Y=(0.3,0.5,0.2)$.$X=0$ の行だけを取り出し,行和0.4で割って合計を1にすると$$P(Y=0\mid X=0)=\frac{0.10}{0.40}=0.25,\quad P(Y=1\mid X=0)=\frac{0.20}{0.40}=0.5,$$ 同様に $P(Y=2\mid X=0)=0.25$.
連続型の $f_X(x)=\int f(x,y)\,\mathrm{d}y$ は,表の「行和」を連続版にしたものです.$x$ を固定して,$y$ 方向に全部足し合わせる(積分する).これを「$y$ を積分して消す」「$y$ 方向に潰す」と言ったりします.
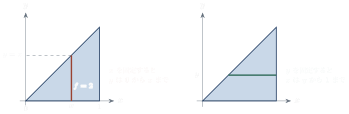
同時密度が三角形などの領域でだけ正のとき,周辺密度を求める積分の範囲は$x$ によって変わります.たとえば $0<y<x<1$ で $f(x,y)=2$ なら,$$f_X(x)=\int_0^{x}2\,\mathrm{d}y=2x\ (0<x<1),\qquad f_Y(y)=\int_y^{1}2\,\mathrm{d}x=2(1-y)\ (0<y<1).$$ $\int_0^1 2\,\mathrm{d}y=2$ のように全範囲で積分してしまうのは典型的な誤りです.必ず領域の図を描き,$x$ を固定したときの $y$ の動く範囲を読み取りましょう(図2.4).
2.2.3条件付き分布 ── 切り口を取り出して正規化する
$f_X(x)>0$ となる $x$ に対し,$X=x$ が与えられたときの $Y$ の条件付き確率密度関数を$$f_{Y\mid X}(y\mid x)=\frac{f(x,y)}{f_X(x)}$$ で定める.離散型では $p_{Y\mid X}(y\mid x)=p(x,y)/p_X(x)=P(Y=y\mid X=x)$.
同時密度の山を $x=x_0$ の位置で $y$ 軸に平行に切ると,切り口に $y\mapsto f(x_0,y)$ という曲線が現れます.これは「$X=x_0$ のとき $Y$ がどのあたりに出やすいか」の形を表していますが,面積は $\int f(x_0,y)\,\mathrm{d}y=f_X(x_0)$ で1ではありません.そこで $f_X(x_0)$ で割って面積を1に直したものが条件付き密度です.第1章の条件付き確率「世界を $B$ に絞り込み,面積を1に直す」とまったく同じ発想です.
$(X,Y)$ の同時密度を $f(x,y)=x+y\ (0<x<1,\,0<y<1)$ とする.周辺密度,条件付き密度,$P(X+Y\le1)$ を求めよ.
解 周辺密度:$f_X(x)=\int_0^1(x+y)\,\mathrm{d}y=x+\tfrac12\ (0<x<1)$.対称性から $f_Y(y)=y+\tfrac12$.
条件付き密度:$f_{Y\mid X}(y\mid x)=\dfrac{x+y}{x+1/2}\ (0<y<1)$.確かに $\int_0^1\frac{x+y}{x+1/2}\,\mathrm{d}y=\frac{x+1/2}{x+1/2}=1$.
確率:$x+y\le1$ となる三角形の上で積分して$$\begin{aligned} P(X+Y\le1)&=\int_0^1\!\!\int_0^{1-x}(x+y)\,\mathrm{d}y\,\mathrm{d}x=\int_0^1\Bigl\{x(1-x)+\frac{(1-x)^2}{2}\Bigr\}\,\mathrm{d}x\\ &=\int_0^1\frac{1-x^2}{2}\,\mathrm{d}x=\frac13 . \end{aligned}$$
同時密度は「周辺 $\times$ 条件付き」に分解できます:$$f(x,y)=f_X(x)\,f_{Y\mid X}(y\mid x)=f_Y(y)\,f_{X\mid Y}(x\mid y).$$ これは第1章の乗法定理 $P(A\cap B)=P(A)P(B\mid A)$ の密度版です.ここから密度のベイズの定理 $$f_{X\mid Y}(x\mid y)=\frac{f_{Y\mid X}(y\mid x)\,f_X(x)}{\int f_{Y\mid X}(y\mid x')\,f_X(x')\,\mathrm{d}x'}$$ が得られ,第31章のベイズ法(事後分布 $\propto$ 尤度 $\times$ 事前分布)の土台になります.
ワークブックp.8では条件付き確率密度関数が定義されています.ここで注意が2つあります.
誤植:お持ちの刷によっては,p.8下から8行目に「$y$ の条件付き確率密度関数」とありますが,正しくは「$Y$ の条件付き確率密度関数」です(小文字 $y$ は確率変数ではなく,変数の値).正誤表で訂正されています.
記号 $f_{Y\mid X}(y\mid x)$ は「$X=x$ という値に固定したときの,$Y$ の密度を点 $y$ で評価したもの」です.縦棒の右側は条件(固定された値),左側が変数.$x$ はパラメータのように振る舞い,$y$ について積分すると1になります($x$ について積分しても1にはなりません).
2.2.4独立性とその判定
すべての $x,y$ について$$f(x,y)=f_X(x)\,f_Y(y)\quad(\text{離散型なら } p(x,y)=p_X(x)\,p_Y(y))$$ が成り立つとき,$X$ と $Y$ は独立であるという.同値な言い換えとして,$F(x,y)=F_X(x)F_Y(y)$,または($f_X(x)>0$ で)$f_{Y\mid X}(y\mid x)=f_Y(y)$.
最後の言い換え「条件付き分布が $x$ によらない」が,独立性の意味そのものです.$X$ の値を知っても $Y$ の分布についての情報が何も増えない,ということです.図2.5では,$x_0$ によって条件付き密度の形が変わっているので独立ではありません.
同時密度が$$f(x,y)=g(x)\,h(y)\quad(\text{すべての }x,y)$$ と,$x$ だけの関数と $y$ だけの関数の積に分解できるならば,$X$ と $Y$ は独立である.このとき $f_X\propto g$,$f_Y\propto h$.
因数分解定理の導出到達度:理解 $c_g=\int g(x)\,\mathrm{d}x$,$c_h=\int h(y)\,\mathrm{d}y$ とおくと,全体の積分が1なので $c_gc_h=1$.$f_X(x)=\int g(x)h(y)\,\mathrm{d}y=c_h\,g(x)$,$f_Y(y)=c_g\,h(y)$.よって $f_X(x)f_Y(y)=c_gc_h\,g(x)h(y)=f(x,y)$.
□
この判定法で最も間違えやすいのが定義域です.$0<y<x<1$ で $f(x,y)=2$(図2.4)は,式だけ見ると定数で「分解できている」ように見えますが,定義域の条件を指示関数で書くと$$f(x,y)=2\cdot\mathbb{1}(0<y<x<1)$$ で,$\mathbb{1}(y<x)$ は $x$ と $y$ の積に分けられません.実際,$f_X(x)f_Y(y)=4x(1-y)$ は $f(x,y)$ と一致しないので独立ではありません.直観的にも「$X=0.1$ と分かれば $Y<0.1$ に限られる」ので,情報が増えています.定義域が長方形(直積 $A\times B$)でなければ独立ではないと覚えましょう.
次の同時密度をもつ $(X,Y)$ は独立か.(a) $f(x,y)=6e^{-2x-3y}\ (x>0,y>0)$ (b) $f(x,y)=x+y\ (0<x,y<1)$ (c) $f(x,y)=8xy\ (0<x<y<1)$
解 (a) $6e^{-2x-3y}=(2e^{-2x})(3e^{-3y})$ で定義域も直積 $(0,\infty)^2$.独立で,$X\sim\mathrm{Ex}(2)$,$Y\sim\mathrm{Ex}(3)$.
(b) $x+y$ は積に分解できない.実際 $f_X(x)f_Y(y)=(x+\frac12)(y+\frac12)\neq x+y$.独立でない.
(c) 式は $8xy$ と積の形だが,定義域 $0<x<y<1$ が直積でない.独立でない.
$X_1,\dots,X_n$ が(相互に)独立とは,同時密度が $f(x_1,\dots,x_n)=\prod_{i=1}^n f_i(x_i)$ と周辺密度の積になることです.さらに周辺分布がすべて同じとき独立同一分布(i.i.d.)といい,$X_1,\dots,X_n\overset{\text{i.i.d.}}{\sim}f$ と書きます.統計学の「無作為標本」はこれを数学的に表したもので,第8章以降の尤度関数 $L(\theta)=\prod f(x_i;\theta)$ は,この積の形から来ています.
$X,Y$ が独立なら,$g(X)$ と $h(Y)$ も独立です.したがって ${\operatorname{E}}[g(X)h(Y)]={\operatorname{E}}[g(X)]\,{\operatorname{E}}[h(Y)]$ が成り立ちます(積分が $\int g f_X\,\mathrm{d}x\cdot\int hf_Y\,\mathrm{d}y$ と分かれるため).この性質が,次節の「独立な和の母関数は積」の根拠になります.
2.3母関数◆合格基盤
2.3.1母関数の発想 ── 数列を一本の関数にしまう
母関数という名前は,数学の母関数(generating function)から来ています.数列 $a_0,a_1,a_2,\dots$ を$$G(s)=a_0+a_1s+a_2s^2+\cdots$$ という一本の関数の係数として「しまっておく」と,数列の操作が関数の操作(かけ算・微分)に置き換わって計算が楽になる,というアイデアです.
サイコロ1個の目の分布を,確率を係数とする多項式で表します:$$G(s)=\tfrac16\bigl(s+s^2+s^3+s^4+s^5+s^6\bigr).$$ 2個のサイコロの和の分布は,$G(s)^2$ を展開したときの $s^k$ の係数です.たとえば $s^4$ の係数は $s^1s^3,\ s^2s^2,\ s^3s^1$ の3通りから $3/36$ ── これは「和が4になる組合せを数える」作業そのものです.指数の足し算($s^a\cdot s^b=s^{a+b}$)が,確率変数の足し算を自動的に処理してくれるのです(図2.6).
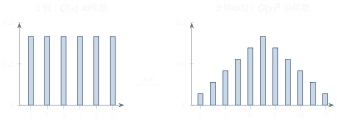
確率論の母関数は,この発想を期待値の形で書いたものです.$G(s)=\sum_k p(k)s^k={\operatorname{E}}[s^X]$ ですから,「$s^X$ の期待値」と書けば離散・連続を問わず定義が拡張できます.以下,3種類(+1種類)の母関数を順に見ていきます.
| 名前 | 定義 | 取り出せるもの | 主な用途 |
|---|---|---|---|
| 確率母関数 | $G(s)={\operatorname{E}}[s^X]$ | $p(k)=G^{(k)}(0)/k!$ | 非負整数値の分布 |
| 積率母関数 | $M(t)={\operatorname{E}}[e^{tX}]$ | ${\operatorname{E}}[X^k]=M^{(k)}(0)$ | モーメント・再生性 |
| 特性関数 | $\phi(t)={\operatorname{E}}[e^{itX}]$ | ${\operatorname{E}}[X^k]=\phi^{(k)}(0)/i^k$ | 常に存在・極限定理 |
| キュムラント母関数 | $K(t)=\log M(t)$ | 平均・分散・歪度など | 和の特性値 |
2.3.2確率母関数
非負の整数値をとる確率変数 $X$ に対し,$$G_X(s)={\operatorname{E}}[s^X]=\sum_{k=0}^\infty P(X=k)\,s^k\qquad(|s|\le1)$$ を確率母関数(probability generating function, pgf)という.
$|s|\le1$ なら $\sum P(X=k)|s|^k\le\sum P(X=k)=1$ なので,確率母関数は必ず存在します.$G(1)=\sum P(X=k)=1$ も常に成り立ちます.
確率の復元:$P(X=k)=\dfrac{G^{(k)}(0)}{k!}$.したがって $G$ が一致すれば分布も一致する.
階乗モーメント:$G'(1)={\operatorname{E}}[X]$,$G''(1)={\operatorname{E}}[X(X-1)]$,一般に $G^{(r)}(1)={\operatorname{E}}[X(X-1)\cdots(X-r+1)]$.
分散:${\operatorname{V}}[X]=G''(1)+G'(1)-\{G'(1)\}^2$.
(2)(3) は,対応するモーメントが有限のときに成り立つ.$s=1$ は収束域 $|s|\le1$ の端なので,$G^{(r)}(1)$ は $s\uparrow1$ とした左からの極限 $\lim_{s\uparrow1}G^{(r)}(s)$ の意味である(モーメントが無限大なら,この極限も $+\infty$ になる).
確率母関数の性質の導出到達度:導出 (1) $G(s)=p_0+p_1s+p_2s^2+\cdots$ を $k$ 回微分すると,$s^j\ (j<k)$ の項は消え,$s^k$ の項は $k!\,p_k$,$s^j\ (j>k)$ の項は $s$ の正のべきを含む.$s=0$ を代入すると $k!\,p_k$ だけが残る(テイラー展開の係数と同じ).
(2) $\sum_k p_k s^k$ を項別に微分して$$G'(s)=\sum_k k\,p_k\,s^{k-1},\qquad G''(s)=\sum_k k(k-1)\,p_k\,s^{k-2}.$$ $s=1$ を代入すると $s$ のべきがすべて1になり,$G'(1)=\sum k\,p_k={\operatorname{E}}[X]$,$G''(1)=\sum k(k-1)p_k={\operatorname{E}}[X(X-1)]$.
(3) ${\operatorname{E}}[X^2]={\operatorname{E}}[X(X-1)]+{\operatorname{E}}[X]=G''(1)+G'(1)$ を ${\operatorname{V}}[X]={\operatorname{E}}[X^2]-({\operatorname{E}}[X])^2$ に代入.
□
確率母関数では,$s=0$ の近くの情報が個々の確率を,$s=1$ の近くの情報がモーメントを表します.$s=0$ を代入すると $s$ を含む項がすべて消えて定数項だけ残る,$s=1$ を代入すると $s^k$ がすべて1になって「全部の和」になる ── この2つの性質を使い分けていると理解してください.
(a) $X\sim\mathrm{Bin}(n,p)$,(b) $X\sim\mathrm{Po}(\lambda)$ の確率母関数を求め,平均と分散を導け.
解 (a) 二項定理より$$G(s)=\sum_{k=0}^n\binom nk p^k(1-p)^{n-k}s^k=\sum_{k=0}^n\binom nk (ps)^k(1-p)^{n-k}=(1-p+ps)^n .$$ $G'(s)=np(1-p+ps)^{n-1}$,$G''(s)=n(n-1)p^2(1-p+ps)^{n-2}$ より $G'(1)=np$,$G''(1)=n(n-1)p^2$.${\operatorname{V}}[X]=n(n-1)p^2+np-n^2p^2=np-np^2=np(1-p)$.
(b) 指数関数のテイラー展開 $e^u=\sum u^k/k!$ を使って$$G(s)=\sum_{k=0}^\infty e^{-\lambda}\frac{\lambda^k}{k!}s^k=e^{-\lambda}\sum_{k=0}^\infty\frac{(\lambda s)^k}{k!}=e^{-\lambda}e^{\lambda s}=e^{\lambda(s-1)}.$$ $G'(1)=\lambda$,$G''(1)=\lambda^2$ より ${\operatorname{E}}[X]=\lambda$,${\operatorname{V}}[X]=\lambda^2+\lambda-\lambda^2=\lambda$.
2.3.3積率母関数
確率母関数は非負整数値にしか使えません.そこで $s=e^t$ と置き換えて,実数値の確率変数一般に拡張したものが積率母関数です.
$$M_X(t)={\operatorname{E}}[e^{tX}]=\begin{cases}\displaystyle\sum_x e^{tx}p(x) & (\text{離散型})\\[2ex] \displaystyle\int_{-\infty}^\infty e^{tx}f(x)\,\mathrm{d}x & (\text{連続型})\end{cases}$$ が $t=0$ を含むある開区間 $(-h,h)$ で有限であるとき,$M_X(t)$ を積率母関数(moment generating function, mgf)という.
「積率」はモーメント(moment)の訳語で,${\operatorname{E}}[X^k]$ を $k$ 次の(原点まわりの)積率といいます.
$M_X(t)$ が $t=0$ を含む開区間で有限ならば,すべての次数のモーメントが有限で$$M_X^{(k)}(0)={\operatorname{E}}[X^k]\qquad(k=1,2,\dots),$$ すなわち $M_X(t)=\displaystyle\sum_{k=0}^\infty\frac{{\operatorname{E}}[X^k]}{k!}t^k=1+{\operatorname{E}}[X]\,t+\frac{{\operatorname{E}}[X^2]}{2!}t^2+\frac{{\operatorname{E}}[X^3]}{3!}t^3+\cdots$.
なぜ微分でモーメントが出るのか到達度:理解 指数関数のテイラー展開$$e^{tX}=1+tX+\frac{(tX)^2}{2!}+\frac{(tX)^3}{3!}+\cdots$$ の両辺の期待値をとると,期待値の線形性(無限和との交換は,$M$ が $(-h,h)$ で有限なら正当化できる)より$$M_X(t)=1+t\,{\operatorname{E}}[X]+\frac{t^2}{2!}{\operatorname{E}}[X^2]+\frac{t^3}{3!}{\operatorname{E}}[X^3]+\cdots .$$ つまり $M_X(t)$ はモーメントを係数にもつベキ級数です.$k$ 回微分して $t=0$ を代入すると,確率母関数のときと同じ理屈で $t^k$ の項の係数 $\times\,k!$,すなわち ${\operatorname{E}}[X^k]$ だけが残ります.
別の見方をすると,$\dfrac{\mathrm d}{\mathrm dt}e^{tX}=Xe^{tX}$ ですから,期待値の中で微分すると$$M'(t)={\operatorname{E}}[Xe^{tX}],\quad M''(t)={\operatorname{E}}[X^2e^{tX}],\quad\dots,\quad M^{(k)}(t)={\operatorname{E}}[X^ke^{tX}].$$ $t=0$ で $e^{0}=1$ となり,${\operatorname{E}}[X^k]$ が残ります.微分するたびに $X$ が1つ前に降りてくる,というのが仕組みです.
□
$X\sim\mathrm{Ex}(\lambda)$ の積率母関数を求め,${\operatorname{E}}[X]$,${\operatorname{V}}[X]$ を導け.
解 $t<\lambda$ のとき$$M(t)=\int_0^\infty e^{tx}\lambda e^{-\lambda x}\,\mathrm{d}x=\lambda\int_0^\infty e^{-(\lambda-t)x}\,\mathrm{d}x=\frac{\lambda}{\lambda-t}.$$ ($t\ge\lambda$ では積分が発散するが,$0$ の近く $(-\lambda,\lambda)$ で有限なので積率母関数は存在する.)$M(t)=\lambda(\lambda-t)^{-1}$ を微分して$$M'(t)=\lambda(\lambda-t)^{-2},\qquad M''(t)=2\lambda(\lambda-t)^{-3}.$$ ${\operatorname{E}}[X]=M'(0)=1/\lambda$,${\operatorname{E}}[X^2]=M''(0)=2/\lambda^2$,${\operatorname{V}}[X]=2/\lambda^2-1/\lambda^2=1/\lambda^2$.
同様にガンマ分布 $\mathrm{Ga}(\alpha,\beta)$(密度 $\frac{\beta^\alpha}{\Gamma(\alpha)}x^{\alpha-1}e^{-\beta x}$)では $M(t)=\bigl(\frac{\beta}{\beta-t}\bigr)^\alpha$ となります(第6章).
$Z\sim\mathrm{N}(0,1)$ の積率母関数を求めよ.また $X=\mu+\sigma Z\sim\mathrm{N}(\mu,\sigma^2)$ の積率母関数を求めよ.
解 指数部分をまとめて平方完成します:$tz-\frac{z^2}{2}=-\frac{(z-t)^2}{2}+\frac{t^2}{2}$.よって$$M_Z(t)=\int_{-\infty}^\infty e^{tz}\frac{1}{\sqrt{2\pi}}e^{-z^2/2}\,\mathrm{d}z =e^{t^2/2}\int_{-\infty}^\infty\frac{1}{\sqrt{2\pi}}e^{-(z-t)^2/2}\,\mathrm{d}z=e^{t^2/2}.$$ 最後の積分は $\mathrm{N}(t,1)$ の密度の全積分なので1です.次に$$M_X(t)={\operatorname{E}}[e^{t(\mu+\sigma Z)}]=e^{\mu t}\,{\operatorname{E}}[e^{(\sigma t)Z}]=e^{\mu t}M_Z(\sigma t)=\exp\Bigl(\mu t+\frac{\sigma^2t^2}{2}\Bigr).$$
最後の計算で使った性質は一般的に成り立ちます.
$$M_{aX+b}(t)=e^{bt}M_X(at).$$ (${\operatorname{E}}[e^{t(aX+b)}]=e^{bt}{\operatorname{E}}[e^{(at)X}]$ より.)
2.3.4なぜ母関数で分布が決まるのか
母関数が役に立つ最大の理由は,次の一意性定理です.
$X,Y$ の積率母関数が $0$ を含むある開区間で存在し,その区間で $M_X(t)=M_Y(t)$ ならば,$X$ と $Y$ の分布は等しい.確率母関数・特性関数についても同様(特性関数はすべての $t$ で一致すればよい).
母関数は分布の指紋のようなものです.分布が違えば指紋も違うので,指紋が一致すれば同一人物(同一分布)だと断定できます.たとえば,ある確率変数の積率母関数を計算して $e^{\mu t+\sigma^2t^2/2}$ になったら,その瞬間に「これは $\mathrm{N}(\mu,\sigma^2)$ だ」と結論できます.
確率母関数の場合は,なぜ一意なのかが目に見えます.$G(s)$ が分かれば,$P(X=k)=G^{(k)}(0)/k!$ ですべての確率を具体的に取り出せるからです.関数が同じなら取り出される確率も同じ ── これが一意性の中身です.
積率母関数についても,$M(t)=\sum{\operatorname{E}}[X^k]t^k/k!$ が $0$ の近くで収束するという条件のもとで,モーメント列 ${\operatorname{E}}[X],{\operatorname{E}}[X^2],\dots$ がすべて決まり,しかも(収束するという条件があるおかげで)モーメント列から分布が一通りに決まる,という構造になっています.積率母関数は数学的にはラプラス変換(特性関数はフーリエ変換)の一種で,これらの変換には逆変換の公式があるため,変換後の関数から元の分布を復元できます.
「すべての次数のモーメントが一致すれば分布が一致する」は一般には正しくありません.対数正規分布は,すべてのモーメント ${\operatorname{E}}[X^k]$ が有限なのに積率母関数が $t>0$ で存在せず,同じモーメント列をもつ別の分布が存在することが知られています.一意性定理が「積率母関数が $0$ の近くで存在すれば」という条件付きなのはこのためです.試験で深入りすることはありませんが,条件の意味として知っておきましょう.
2.3.5独立な確率変数の和 ── 畳み込みがかけ算になる
$X$ と $Y$ が独立ならば$$\begin{gathered} M_{X+Y}(t)=M_X(t)\,M_Y(t),\qquad G_{X+Y}(s)=G_X(s)\,G_Y(s),\\ \phi_{X+Y}(t)=\phi_X(t)\,\phi_Y(t). \end{gathered}$$ $X_1,\dots,X_n$ が独立なら $M_{X_1+\cdots+X_n}(t)=\prod_{i=1}^nM_{X_i}(t)$.特に i.i.d. なら $\{M_{X_1}(t)\}^n$.
なぜ積になるのか到達度:導出 指数法則 $e^{t(X+Y)}=e^{tX}e^{tY}$ で,$e^{tX}$ は $X$ だけの関数,$e^{tY}$ は $Y$ だけの関数です.$X,Y$ が独立なら(前節のコラム),関数どうしも独立で,積の期待値は期待値の積になります:$$M_{X+Y}(t)={\operatorname{E}}[e^{tX}e^{tY}]={\operatorname{E}}[e^{tX}]\,{\operatorname{E}}[e^{tY}]=M_X(t)M_Y(t).$$ 連続型で書けば,$\iint e^{tx}e^{ty}f_X(x)f_Y(y)\,\mathrm{d}x\,\mathrm{d}y=\int e^{tx}f_X\,\mathrm{d}x\cdot\int e^{ty}f_Y\,\mathrm{d}y$ と2重積分が積に分かれる,ということです.
□
和 $X+Y$ の密度を直接求めるには,畳み込み(convolution)$$f_{X+Y}(z)=\int_{-\infty}^{\infty}f_X(x)\,f_Y(z-x)\,\mathrm{d}x$$ という積分が必要です(「$X=x$ で $Y=z-x$」となる組合せを全部足す).これは面倒な計算です.ところが母関数の世界に翻訳すると,この面倒な畳み込みがただのかけ算になります.$$\begin{array}{ccc} \text{分布の世界} & & \text{母関数の世界}\\ f_X,\ f_Y & \xrightarrow{\ \text{変換}\ } & M_X,\ M_Y\\ \downarrow\ \text{畳み込み(難)} & & \downarrow\ \text{かけ算(易)}\\ f_{X+Y} & \xleftarrow{\ \text{一意性で逆翻訳}\ } & M_XM_Y \end{array}$$ 対数をとると積が和になるので計算尺が掛け算を楽にしたのと同じく,「難しい操作を簡単な操作に変換して計算し,最後に戻す」という数学の定番の戦略です.
(a) $X\sim\mathrm{Po}(\lambda_1)$,$Y\sim\mathrm{Po}(\lambda_2)$ が独立なら $X+Y\sim\mathrm{Po}(\lambda_1+\lambda_2)$ を示せ.(b) $X\sim\mathrm{N}(\mu_1,\sigma_1^2)$,$Y\sim\mathrm{N}(\mu_2,\sigma_2^2)$ が独立なら $X+Y\sim\mathrm{N}(\mu_1+\mu_2,\sigma_1^2+\sigma_2^2)$ を示せ.
解 (a) $G_{X+Y}(s)=e^{\lambda_1(s-1)}e^{\lambda_2(s-1)}=e^{(\lambda_1+\lambda_2)(s-1)}$.これは $\mathrm{Po}(\lambda_1+\lambda_2)$ の確率母関数なので,一意性定理より $X+Y\sim\mathrm{Po}(\lambda_1+\lambda_2)$.
(b) $M_{X+Y}(t)=e^{\mu_1t+\sigma_1^2t^2/2}e^{\mu_2t+\sigma_2^2t^2/2}=\exp\bigl\{(\mu_1+\mu_2)t+(\sigma_1^2+\sigma_2^2)t^2/2\bigr\}$.これは $\mathrm{N}(\mu_1+\mu_2,\sigma_1^2+\sigma_2^2)$ の積率母関数.
このように,同じ分布族の独立な和が再び同じ族に属する性質を再生性といいます.二項分布($p$ が共通),ガンマ分布($\beta$ が共通),カイ二乗分布なども再生性をもち,すべて母関数の積で一瞬で示せます(第5・6章).
確率母関数は非負整数値の確率変数にしか定義しません($s=0$ で確率,$s=1$ でモーメント).積率母関数は $t=0$ の近くで有限でなければ使えず,微分して代入するのは $t=0$ です(キュムラント母関数も同じ).$t$ 分布(自由度が有限)や対数正規分布,コーシー分布のように積率母関数が存在しない分布では,特性関数を使います.
$M_{X+Y}=M_XM_Y$ は独立性を使って導いたので,独立でない場合は一般に成り立ちません.極端な例として $Y=X$ なら $M_{X+Y}(t)=M_X(2t)$ で,$M_X(t)^2$ とは違います.「和の期待値は期待値の和」(独立性不要)と混同しないように.
個数 $N$ 自体が確率変数である和 $S=X_1+\cdots+X_N$($N$ と $X_i$ はすべて独立,$X_i$ は i.i.d.)を考えます.$N=n$ を条件にすると ${\operatorname{E}}[s^S\mid N=n]=G_X(s)^n$ なので,繰り返し期待値の法則より$$G_S(s)={\operatorname{E}}\bigl[G_X(s)^N\bigr]=G_N\bigl(G_X(s)\bigr)$$ と,母関数の合成になります.たとえば来店者数 $N\sim\mathrm{Po}(\lambda)$,各客が確率 $p$ で購入($X_i\sim$ ベルヌーイ,$G_X(s)=1-p+ps$)なら$$G_S(s)=e^{\lambda\{(1-p+ps)-1\}}=e^{\lambda p(s-1)}$$ で,購入者数は $\mathrm{Po}(\lambda p)$ に従います(ポアソン分布の間引き).第15章の複合ポアソン過程はこの構造です.
2.3.6特性関数◇満点補強
積率母関数には「存在しないことがある」という弱点があります.たとえばコーシー分布(密度 $\frac{1}{\pi(1+x^2)}$)では,$t\neq0$ で $\int e^{tx}\frac{1}{\pi(1+x^2)}\,\mathrm{d}x$ が発散します.これを克服するのが特性関数です.
$i$ を虚数単位($i^2=-1$)として,$$\phi_X(t)={\operatorname{E}}[e^{itX}]={\operatorname{E}}[\cos tX]+i\,{\operatorname{E}}[\sin tX]\qquad(-\infty<t<\infty)$$ を特性関数(characteristic function)という.
複素数の指数関数はオイラーの公式 $e^{i\theta}=\cos\theta+i\sin\theta$ で定義されます.複素平面上で $e^{i\theta}$ は,原点を中心とする半径1の円周上の,角度 $\theta$ の点です.したがって $|e^{i\theta}|=\sqrt{\cos^2\theta+\sin^2\theta}=1$ で,$e^{i(a+b)}=e^{ia}e^{ib}$ という指数法則もそのまま成り立ちます.
常に存在する:$|e^{itX}|=1$ なので $|\phi_X(t)|\le{\operatorname{E}}|e^{itX}|=1$.
$\phi_X(0)=1$,$\phi_{aX+b}(t)=e^{ibt}\phi_X(at)$.
${\operatorname{E}}[|X|^k]<\infty$ なら $\phi_X^{(k)}(0)=i^k\,{\operatorname{E}}[X^k]$.
独立なら $\phi_{X+Y}=\phi_X\phi_Y$.特性関数は分布を一意に決める.
積率母関数が存在すれば $\phi_X(t)=M_X(it)$(形式的に $t$ を $it$ に置き換える).
$e^{tX}$ は $X$ が大きいと爆発的に大きくなるので,裾の重い分布では期待値が無限大になります.一方 $e^{itX}$ は単位円の上をぐるぐる回るだけで,絶対値はいつも1です.どんなに $X$ が大きくても値が暴れないので,期待値が必ず有限になります.その代償として複素数を扱う必要があります.
例:$\mathrm{N}(\mu,\sigma^2)$ の特性関数は $\exp(i\mu t-\sigma^2t^2/2)$,標準コーシー分布は $e^{-|t|}$ です.コーシー分布の特性関数は $t=0$ で微分できない(とがっている)ので,平均が存在しないことに対応しています.第7章では,中心極限定理を特性関数(または積率母関数)の収束として示します.
2.3.7キュムラント母関数◇満点補強
$$K_X(t)=\log M_X(t)$$ をキュムラント母関数という.$K_X(t)=\sum_{r=1}^\infty\kappa_r\dfrac{t^r}{r!}$ と展開したときの係数 $\kappa_r=K_X^{(r)}(0)$ を $r$ 次のキュムラントという.
$\mu={\operatorname{E}}[X]$,$\mu_r={\operatorname{E}}[(X-\mu)^r]$($r$ 次の中心モーメント)とすると,$$\kappa_1=\mu,\qquad\kappa_2=\mu_2={\operatorname{V}}[X],\qquad\kappa_3=\mu_3,\qquad\kappa_4=\mu_4-3\mu_2^2 .$$
$\kappa_1,\kappa_2$ の導出到達度:理解 $K=\log M$ を微分すると$$K'=\frac{M'}{M},\qquad K''=\frac{M''M-(M')^2}{M^2}.$$ $t=0$ で $M(0)=1$,$M'(0)={\operatorname{E}}[X]$,$M''(0)={\operatorname{E}}[X^2]$ なので$$\kappa_1=K'(0)={\operatorname{E}}[X],\qquad\kappa_2=K''(0)={\operatorname{E}}[X^2]-({\operatorname{E}}[X])^2={\operatorname{V}}[X].$$ $\kappa_3,\kappa_4$ は次のように見るのが早い.$X-\mu$ の積率母関数は $e^{-\mu t}M_X(t)$ なので,$K_{X-\mu}(t)=K_X(t)-\mu t$ で,$\kappa_2$ 以降は平行移動で変わらない.そこで $\mu=0$ として,$M(t)=1+u$,$u=\frac{\mu_2}{2}t^2+\frac{\mu_3}{6}t^3+\frac{\mu_4}{24}t^4+\cdots$ とおき,$\log(1+u)=u-\frac{u^2}{2}+\cdots$ を使うと$$K(t)=\frac{\mu_2}{2}t^2+\frac{\mu_3}{6}t^3+\Bigl(\frac{\mu_4}{24}-\frac{\mu_2^2}{8}\Bigr)t^4+\cdots .$$ $t^r/r!$ の係数を読むと $\kappa_3=\mu_3$,$\kappa_4=24\bigl(\frac{\mu_4}{24}-\frac{\mu_2^2}{8}\bigr)=\mu_4-3\mu_2^2$.
□
独立なら $M_{X+Y}=M_XM_Y$ なので,対数をとって$$K_{X+Y}(t)=K_X(t)+K_Y(t),\qquad\text{すなわち}\quad\kappa_r(X+Y)=\kappa_r(X)+\kappa_r(Y).$$ 平均と分散が「独立なら足し算」になるのはよく知られていますが,キュムラントはこれを3次以上にも拡張したものです.また,$\mathrm{N}(\mu,\sigma^2)$ では $K(t)=\mu t+\sigma^2t^2/2$ なので $\kappa_3=\kappa_4=\cdots=0$.3次・4次のキュムラントは「正規分布からのずれ」を測る量で,第3章の歪度 $\kappa_3/\kappa_2^{3/2}$,(超過)尖度 $\kappa_4/\kappa_2^2$ につながります.
$X\sim\mathrm{Po}(\lambda)$ のキュムラントをすべて求め,歪度 $\kappa_3/\kappa_2^{3/2}$ を求めよ.また $n$ 個の i.i.d. の和の歪度はどうなるか.
解 $M(t)=G(e^t)=e^{\lambda(e^t-1)}$ なので $K(t)=\lambda(e^t-1)=\lambda\bigl(t+\frac{t^2}{2!}+\frac{t^3}{3!}+\cdots\bigr)$.よってすべてのキュムラントが $\lambda$.歪度は $\lambda/\lambda^{3/2}=1/\sqrt\lambda$.
一般に i.i.d. の和 $S_n$ では $\kappa_r(S_n)=n\kappa_r$ なので,歪度は$\dfrac{n\kappa_3}{(n\kappa_2)^{3/2}}=\dfrac{1}{\sqrt n}\cdot\dfrac{\kappa_3}{\kappa_2^{3/2}}$ と $1/\sqrt n$ の速さで0に近づきます.和をとるほど分布が左右対称(正規分布)に近づく ── 中心極限定理の姿がここに見えています.
2.3.8多変量の母関数◇満点補強
$(X,Y)$ に対し $M_{X,Y}(t_1,t_2)={\operatorname{E}}[e^{t_1X+t_2Y}]$ を同時積率母関数という.
周辺:$M_X(t_1)=M_{X,Y}(t_1,0)$.
混合モーメント:$\dfrac{\partial^2 M_{X,Y}}{\partial t_1\partial t_2}(0,0)={\operatorname{E}}[XY]$($t_1$ で微分すると $X$,$t_2$ で微分すると $Y$ が降りてくる).
独立性:$X,Y$ が独立 $\iff$ $M_{X,Y}(t_1,t_2)=M_X(t_1)M_Y(t_2)$.
ベクトルでは ${\boldsymbol{t}}=(t_1,\dots,t_p)^\top$ として $M_{{\boldsymbol{X}}}({\boldsymbol{t}})={\operatorname{E}}[e^{{\boldsymbol{t}}^\top{\boldsymbol{X}}}]$ と書きます.第6章の多変量正規分布では $M({\boldsymbol{t}})=\exp({\boldsymbol{t}}^\top{\boldsymbol{\mu}}+\frac12{\boldsymbol{t}}^\top{\boldsymbol{\Sigma}}{\boldsymbol{t}})$ となり,「線形変換しても正規分布」を示す道具になります.
ワークブックp.9〜10では,確率母関数・積率母関数・特性関数・キュムラント母関数の定義と,微分でモーメントが得られることが公式として並んでいます.読むときのポイントは次のとおりです.
微分した後に代入する点:確率母関数は $s=1$ でモーメント(階乗モーメント),$s=0$ で確率.積率母関数・キュムラント母関数は $t=0$.ここを取り違える誤りが多い.
確率母関数の2階微分は ${\operatorname{E}}[X^2]$ ではなく ${\operatorname{E}}[X(X-1)]$(階乗モーメント).分散を出すときは $G''(1)+G'(1)-\{G'(1)\}^2$.
特性関数の $k$ 階微分には $i^k$ がつく.$\phi''(0)=-{\operatorname{E}}[X^2]$ のように符号も変わる.
キュムラントの式 $\kappa_4=\mu_4-3\mu_2^2$ の「$-3$」は,正規分布の $\mu_4=3\sigma^4$ を差し引いている.第3章の尖度の定義(3を引くかどうか)とつながっている.
「独立な確率変数の和の母関数は,母関数の積」は独立性が前提.ワークブックでは簡潔に述べられているが,指数法則 $e^{t(X+Y)}=e^{tX}e^{tY}$ と独立性による期待値の分解の2段階であることを押さえる.
2.4例題に取り組むための考え方◆合格基盤
ワークブックp.11の例題は,分布関数・同時分布・母関数の各道具を実際に使う問題です.出題のタイプごとに方針を整理しておきます.
分布関数から確率を求めるタイプ:$P(a<X\le b)=F(b)-F(a)$ を使う.離散・混在型なら跳びの点での $<$ と $\le$ を区別する.「分布関数か?」と問われたら,単調非減少・右連続・両端の極限の3点を順にチェックする.
同時密度から周辺・条件付きを求めるタイプ:まず定義域の図を描く.周辺密度は「固定した変数に応じた積分範囲」で積分.条件付き密度は同時密度 $\div$ 周辺密度で,最後に「条件側の変数を固定して積分すると1」になることを確かめると計算ミスが見つかる.
独立性を判定するタイプ:式の因数分解と定義域が直積かの両方を確認.独立でないことを示すには,$f(x,y)\ne f_X(x)f_Y(y)$ となる点を1つ挙げれば十分.
母関数からモーメントを求めるタイプ:微分の回数と代入点を確認.高次の微分が面倒なときは,テイラー展開の係数を読む($M(t)=\sum{\operatorname{E}}[X^k]t^k/k!$)か,キュムラント母関数 $\log M$ を使うと楽なことが多い.
和の分布を求めるタイプ:母関数の積を計算し,それがどの分布の母関数の形か「見覚えのある形」に整理する.主要な分布の母関数(二項 $(1-p+ps)^n$,ポアソン $e^{\lambda(s-1)}$,指数 $\lambda/(\lambda-t)$,正規 $e^{\mu t+\sigma^2t^2/2}$)は覚えておく.
生存関数による期待値 ${\operatorname{E}}[X]=\int_0^\infty P(X>x)\,\mathrm{d}x$($X\ge0$ のとき)は,打ち切り・最小値・最大値の期待値を求める問題で強力です.$X_1,\dots,X_n$ が独立なら $\min(X_1,\dots,X_n)$ の生存関数は $\prod P(X_i>x)$ と積になるので特に相性がよい.
積率母関数の形から分布を特定させる問題(「$M(t)=(1-2t)^{-3}$ のとき分布は?」)が典型的.
「独立な和の分布」は再生性として答えを覚えておくと数値入力問題で時間を節約できます.
指数分布の生存関数 $e^{-\lambda x}$ などの値が必要なとき,本番(普通電卓)では値が問題文で与えられるか,使わずに済む設定になっていると考えてよいでしょう.与えられた値の組合せ方($e^{-2/3}=(e^{-1/3})^2$ など)を練習しておきます.
条件付き密度から条件付き期待値を計算する問題は第3章の分散の分解とセットで出題されます.
この章の内容は,別冊の問題集 第2章(問2.1〜2.10)で演習できます.
分布関数の3性質(単調非減少・右連続・両端の極限)を述べ,与えられた関数が分布関数かどうか判定できる.
跳びの高さ $F(a)-F(a-)$ が $P(X=a)$ であることを使い,$<$ と $\le$ を区別して確率を計算できる.
混在型の分布を,離散部分と連続部分に分けて扱える.
$X\ge0$ のとき ${\operatorname{E}}[X]=\int_0^\infty P(X>x)\,\mathrm{d}x$ を導出でき,打ち切りのある量の期待値に使える(非負でない変数には使えないことも説明できる).
同時分布から周辺分布(行和・積分)と条件付き分布(切り口の正規化)を求められる.
独立性を,因数分解と定義域(直積かどうか)の両面から判定できる.
確率母関数から確率($s=0$)と階乗モーメント($s=1$)を取り出せる.
積率母関数を微分すると ${\operatorname{E}}[X^k]$ が出る理由を,テイラー展開または「$X$ が降りてくる」で説明できる.
独立な和の母関数が積になる理由を説明し,再生性の証明に使える.
特性関数が常に存在する理由と,キュムラントが独立な和で加法的になることを説明できる.
統計検定準1級 合格ナビ:統計検定準1級の学習アプリ。参考書33章と演習・模試あわせて374問を、解説つきでスマホ・パソコンのブラウザで。第1〜3章の問題と参考書は登録なしで無料。全章は1,980円の買い切り。
アプリを無料で開く有料版と無料版の違い